识别公式保持加粗:粗体变量识别后丢粗的3种补法
更新于
识别公式保持加粗,关键在识别之后核对源码:粗体只有写成 \mathbf、\boldsymbol 或 \bm 这类命令才算数,识别结果里如果只剩普通字母,就要手动补回去。三种补法各管一类字母:拉丁字母的向量与矩阵用 \mathbf,希腊字母和要保留斜体的用 \boldsymbol,要放进 LaTeX 文档、又嫌命令长的用 \bm。下面用机器学习课件里最常见的线性回归模型走一遍。
截图前先让粗细分得出来
粗体和常规体只差笔画粗细,图一小就糊成一样。截图时把页面放大到公式字母足够大再截,让 X 和 x 的笔画粗细肉眼可辨;课件投影拍照、字很细的讲义扫描件,粗细更难分,识别后要逐个字母核对。
本站图片识别收 PNG / JPG / BMP / WEBP / GIF,单张不超过 20MB,一次一张,要登录并开通本站会员。在公式编辑页点「识别」→「图片识别」,弹窗开着时按 Ctrl+V(Mac 上 ⌘V)粘贴截图,识别直接开始;上传或拖入的图片要点「开始识别」。识别后先出结果卡片,点「插入」才插到编辑区光标处。
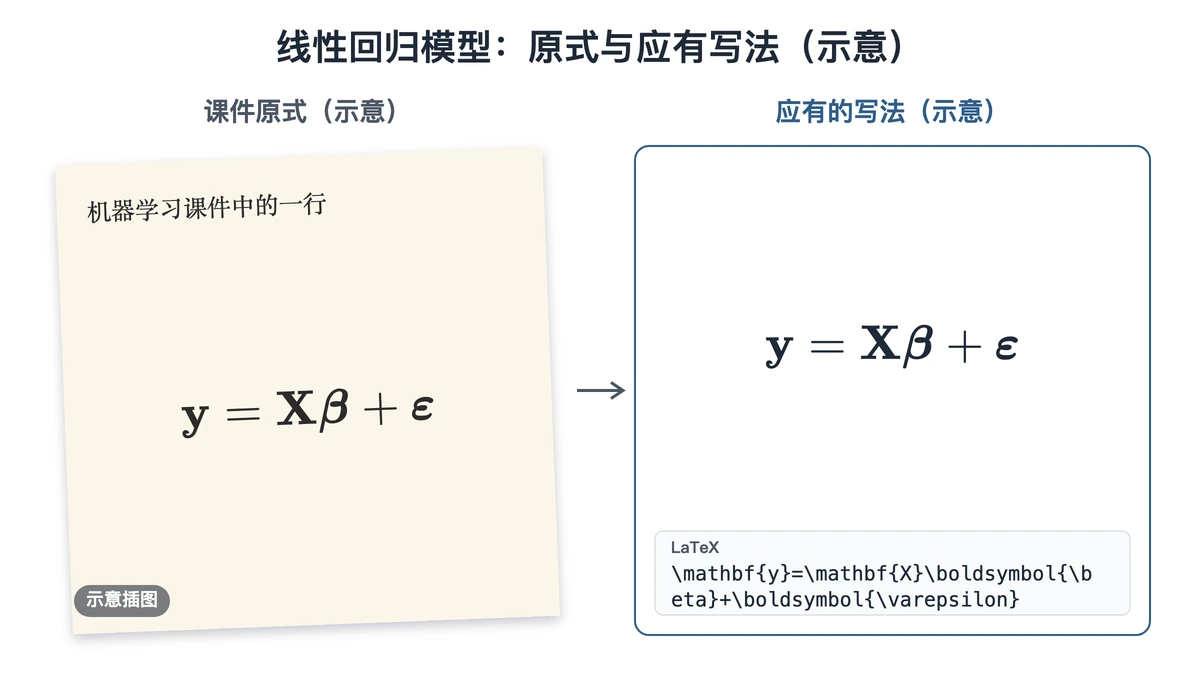
以线性回归模型为例,课件原式里 y、X 是粗体拉丁字母,β、ε 是粗体希腊字母。校对后应得到:
\mathbf{y}=\mathbf{X}\boldsymbol{\beta}+\boldsymbol{\varepsilon}
丢粗之后怎么认出来
把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」看源码,比看预览可靠:预览里粗细差一点不容易察觉,源码里有没有加粗命令一眼就能看清。上面这条的源码里应当数得出 4 个加粗命令,少一个就是丢了一处。
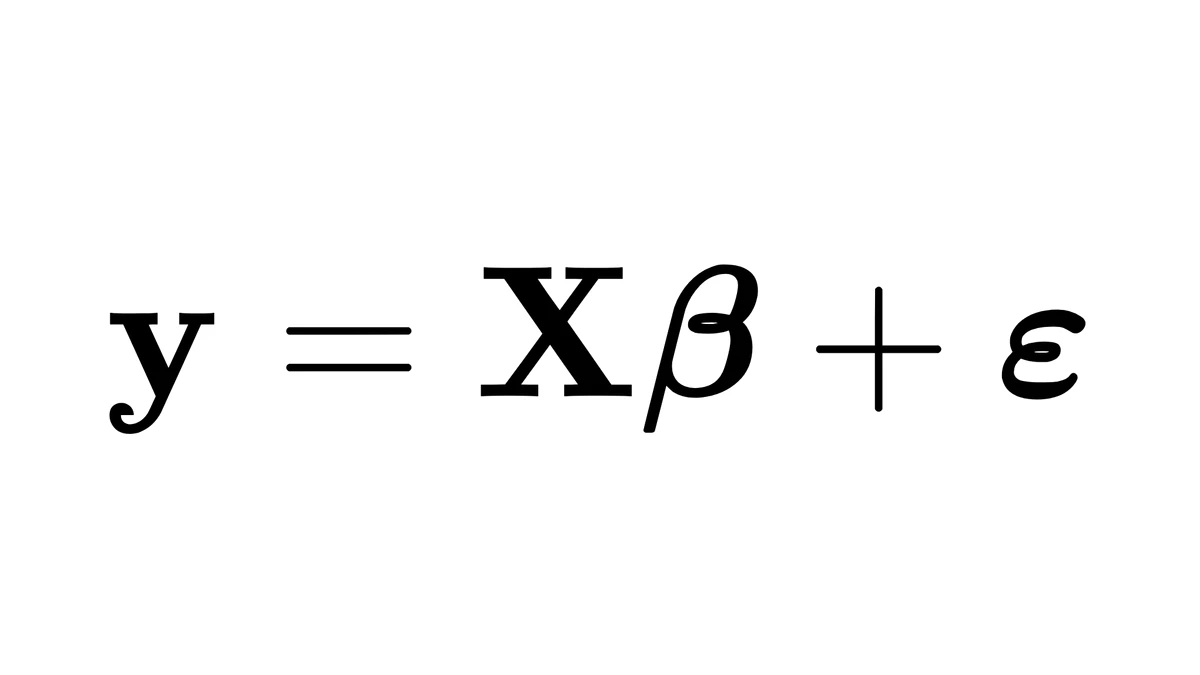
下图是按印刷体画的前后对照示意:左边是课件原式,右边是校对后应有的写法,不是真实识别输出。
核对时逐个问:这个字母在原图里是不是粗的。常见约定是小写粗体表示向量、大写粗体表示矩阵、普通斜体表示标量;同一个 y,粗体是一列观测值,细体只是一个数,丢了粗意思就变了。
三种补法各管哪类字母
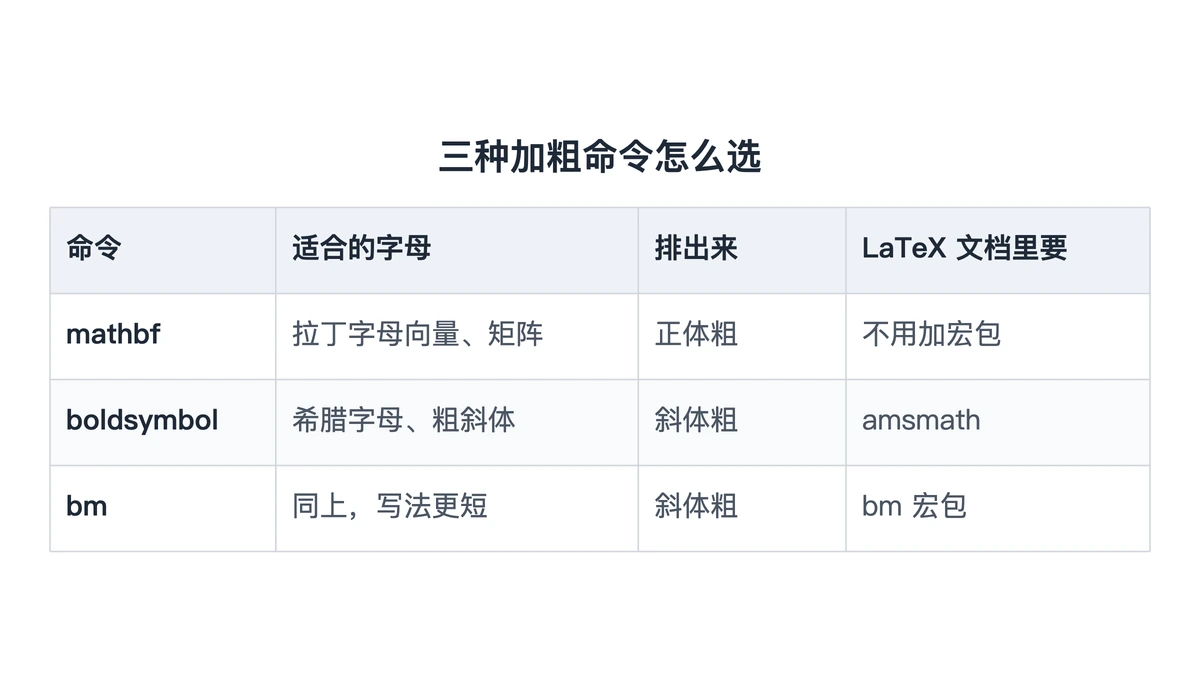
\mathbf:拉丁字母的向量、矩阵。 排出来是正体加粗,适合 y、X 这类。它管不了小写希腊字母:写成\mathbf{\beta},β 仍是普通细体,而且不报错,最容易漏看。\boldsymbol:希腊字母,或想保留斜体的粗体。 β、ε、θ 这类参数向量都用它。本站编辑区能直接输入,预览显示为粗斜体。放进 LaTeX 文档时,导言区要有\usepackage{amsmath},没有就报Undefined control sequence。\bm:LaTeX 文档里的短写法。 效果和\boldsymbol基本一致,需要\usepackage{bm}。公式只在本站编辑、导出时,用前两种就够。
补完一处,在「LaTeX」模式里看命令包住的范围:只把该粗的那个字母包进去,别让一个加粗命令包住整行,否则等号、括号和标量也跟着变粗。
补完后核对三处
最小二乘估计里粗体更密,适合拿来练手:
\mathbf{b}=(\mathbf{X}^{\top}\mathbf{X})^{-1}\mathbf{X}^{\top}\mathbf{y}
其中 b 是 β 的最小二乘估计。
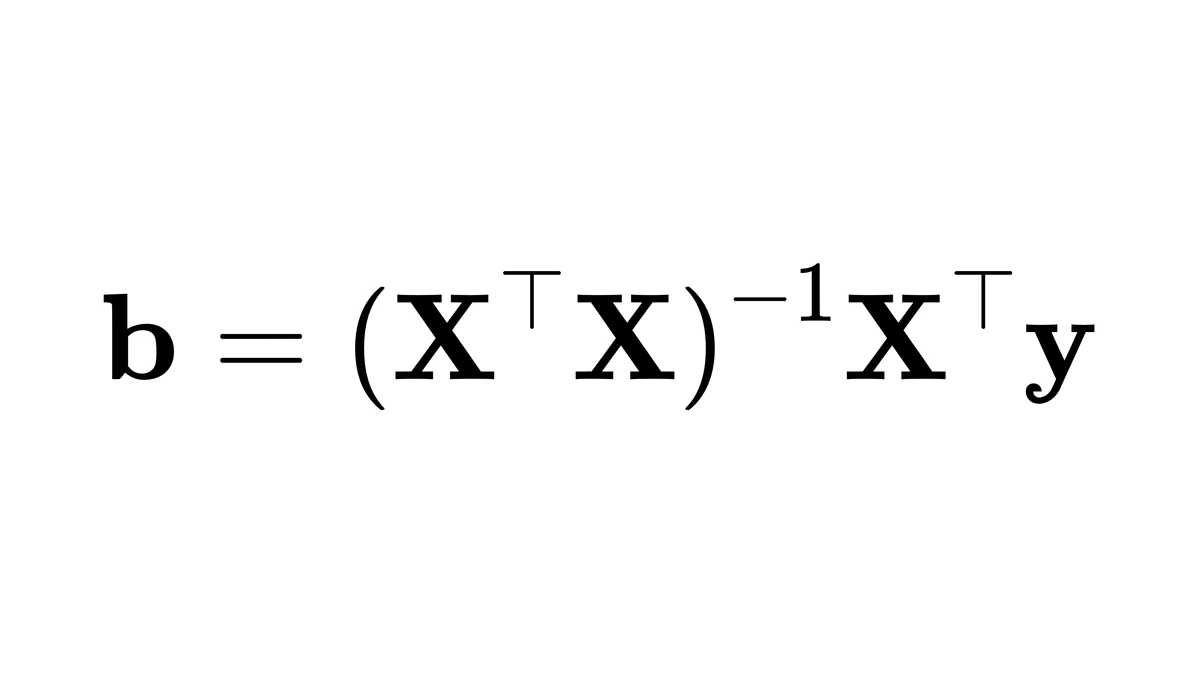
- 转置符号别加粗。 上标里的 ⊤ 是运算记号,写在
\mathbf{X}^{\top}的花括号外面。 - 向量和矩阵一起加粗。 等号两边的 b、X、y 都是向量或矩阵,逐个核对是否都写成了
\mathbf{…},漏掉一个排出来就粗细不一。 - 导出前切回「可视化」模式。 在「LaTeX」模式下顶栏「导出」是灰的;切回后先在预览里确认每个该粗的字母都是粗的,再选「Word(含公式)」。
还没确认账号能不能用识别,先看公式识别登录限制;截图里上下标也小的,一并参考截图公式上下标识别。
这一节课件如果还有损失函数、梯度那几行,按同样的办法识别一条、核一条:先数原图里有几个粗字母,再数源码里有几个加粗命令,两个数对上了再往下走。
延伸阅读
- OCR 识别数学公式:图片公式识别的准备、校对与导出总览
- 截图公式上下标识别:看清上下标位置再导出
- 低清扫描公式识别:模糊页面怎么补救
常见问题
- 导出Word后粗体还在吗?
- 先看源码。单条公式用「Word(含公式)」导出时,源码里用 mathbf 命令加粗的字母导出后仍是粗体,公式可双击修改;boldsymbol 在编辑区能输入、预览是粗斜体。前提是源码里确实写了加粗命令:识别结果里没有,导出后自然也不会变粗,所以导出前先在 LaTeX 模式里把粗体补齐。