扫描PDF双栏转 LaTeX:拆栏后再合并
更新于
扫描PDF双栏转 LaTeX 同时受两类问题影响:图像不够清楚,以及文字阅读顺序不等于横向扫描顺序。若先沿页面中线裁开,再发现整页倾斜,长公式可能已经被截断。应先处理可读性,再安排各栏内容,最后按原文关系合并。
校正为拆栏提供可靠的边界
从完整扫描页开始,检查两栏正文的基线是否朝同一方向歪斜,以及书脊是否遮挡了某一栏。保存原文件,在副本上试做小幅调整。校正后比较四周细节,确认左右边缘的公式没有因旋转或裁切而损失。
两栏之间的空白不一定始终笔直。图表、跨栏标题和长公式可能占用这一区域,不能拿一条从上到下的直线当作通用切分线。先圈出这些例外,再为剩余的普通正文确定栏位,才能知道哪些内容需要独立处理。
还应看页眉、页脚与正文之间的界限。期刊名、页码和扫描留下的黑带可能紧贴内容,尤其在低清页面中容易混入。把它们单独标记,保留在原页参照里,后续公式输入图则尽量避开这些无关部分。
按段落给左右栏编号
在来源记录中给每栏的段落依次标号,并记下开头和结束位置。文字跨页或从左栏末尾接到右栏开头时,在记录中写明。不要根据截图片数推断段落数量,同一段可能因为版面被分开,多个短段也可能出现在一张图里。
逐段转写普通文字,遇到公式再单独准备完整区域。每条式子应保留分数线两侧、上下标和附带条件。左栏靠右边的括号即使伸进栏间空白,也仍属于当前公式;判断边界要跟随内容,而不是服从纸面中线。
跨栏式单列,记录它对应哪段解释、是否有编号以及下面的文字是不是条件。合并前暂时不要放进任一栏的末尾,防止同一条在左右两栏各出现一次。若图像模糊,先列出待查位置,避免在后续排版中忘记哪些内容尚未确认。
汇总代码时沿原文顺读一次
按段落记录连接左栏与右栏,再插回跨栏内容。合并后从正文的上一句读到公式,再读到下一句,确认变量解释和引用顺序一致。只检查源码是否能够显示,发现不了把正确公式放到错误段落的问题。
页脚中的脚注也要单独安置,不能变成最后一个公式的下一行。对正文引用的编号,逐一找回相应式子。最后在目标 LaTeX 文稿里预览长式和段落换行,版面需要调整时只改呈现,不凭版面方便省略原有条件。
在局部编辑中消化扫描误差
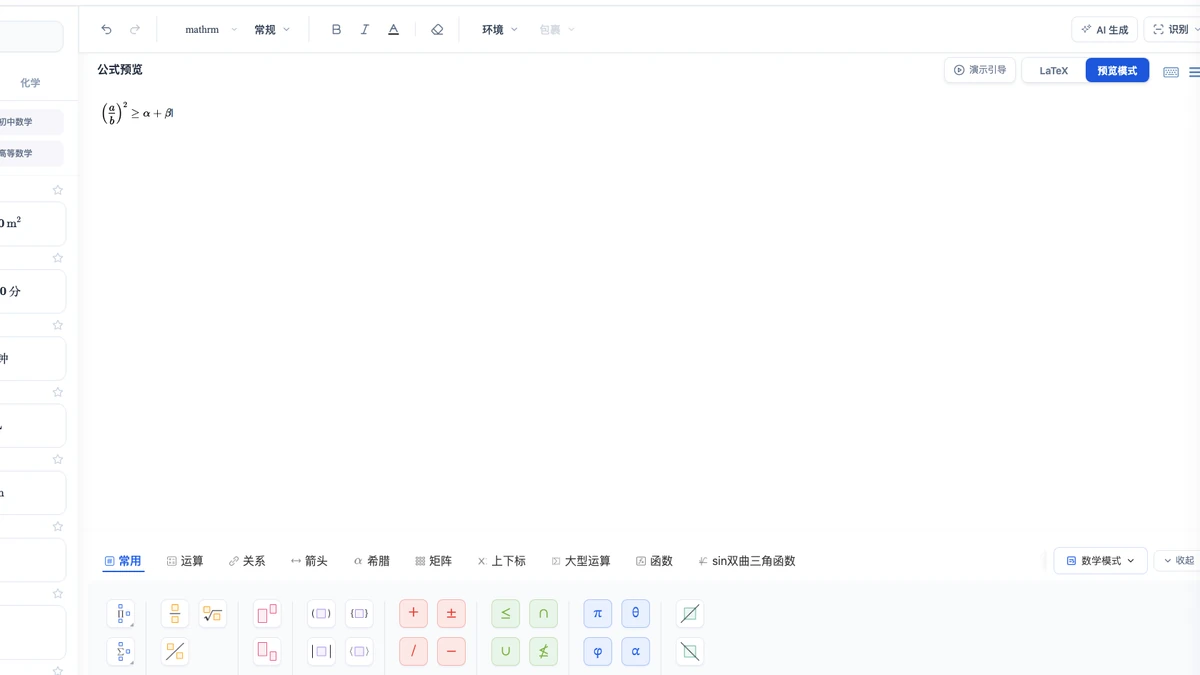
本站图片识别需登录及会员,可用于符合格式与大小要求的公式图片。它与页面校正、整篇论文编排是不同环节。单条结果取得后,在 LaTeX 模式核对源码分组,再从预览看括号与上下层级,优先检查原图中模糊或靠边的部位。
导出源码前切回预览模式,并满足登录和会员要求。把结果放进目标文稿后再次对照原页,不对一次处理就完成所有双栏内容作预期。保留页码、栏位和段落的对应记录,出现漏项时才能直接定位到那一个接缝。
延伸阅读
- 扫描 PDF 转 LaTeX:安排扫描件的完整转写流程。
- 扫描PDF公式截断:补查切分边界附近的缺损内容。
常见问题
- 扫描PDF双栏转 LaTeX 应先校正还是先拆栏?
- 先检查并处理页面整体方向,再根据校正后的内容确定栏界。过早裁成两半可能切断斜着延伸的长公式,原始页也应保留以便比较。
- 扫描PDF双栏转 LaTeX 的跨栏公式怎么处理?
- 将跨栏公式作为独立完整区域,记录它前后的段落和编号。分别整理两栏后按阅读关系插回,不能沿页面中线拆成两条不完整公式。