数学OCR:处理公式时需要多一层判断
更新于
数学OCR处理的是既有字形又有位置关系的内容。扫描结果里出现了原式的全部字符,仍可能漏掉矩阵的一列、把指数挂到错误对象,或把绝对值竖线当成分隔线。校对时多做的一层判断,就是把读出的内容放回它在数学表达中应有的位置与角色。
先为矩阵建立行列坐标
面对矩阵,不妨先忽略具体数字,数清原图有几行几列,外侧是什么括号。再从第一行第一列开始,为每个元素找到对应位置。这样能发现某个空位被压掉后整行内容左移的问题;若直接逐字比,很可能因为数字都出现了而错过位置变化。
省略号要按方向检查。横向省略表示行内延续,竖向省略提示列内延续,斜向省略通常有自己的排列含义。识别结果若把它们统一为普通点号,读者将难以恢复原来的结构。要回到原图看具体布局,不能只用一个省略符替代所有情况。
矩阵周围的标签也应单独核对。行列名称、等号左侧的矩阵名以及旁边的编号,未必属于元素区域。先划分这些内容的身份,再处理内部结构,有助于避免把注释放进第一列或最后一列。
用运算对象解释上下标与分式
上下标检查可以从“这个小字符修饰谁”开始。变量的下标、整组括号的指数和运算符的上下限,外观都是小字符偏离主行,但作用不同。找到它们的宿主后,再核对内部是否还有加减号,不能因为字号小就把几部分合并成一个模糊标记。
分式则要看运算的两个对象。一条长横线可能包含多项分子,短横线也可能位于更大分式内部。先画出外层分子的范围与分母的范围,再逐层向内比较。若输出把两层除法压平,不应只补一条视觉横线,而要恢复正确的嵌套关系。
原图倾斜、行距紧或文字与公式混排时,这些位置判断会更费力。可以将完整公式区域单独整理出来,但留出上下边界,让上下限和外层括号仍然可见。没有足够信息时,保留待核对状态比凭经验补结构更稳妥。
同一个符号需要回到定义中解释
竖线可能用于绝对值,也可能出现在条件概率或行列式中。仅知道“这里有一条竖线”,还不足以决定应该采用怎样的数学结构。先读公式附近的说明,再看成对情况与包围内容,才能判断它承担什么作用。
类似地,字母 i 可能是索引,也可能表示另一个预先定义的量。整理者应保留文稿的约定,不能将所有相同字母统一解释成自己熟悉的含义。识别工具给出的排法最多提供一个候选结果,符号在这段材料中的意义还需要来源支持。
若数学内容将用于计算或论证,应进一步检查适用范围。某个分母是否允许取零,矩阵尺寸是否与相乘对象相容,都不是凭字符相同就能确认的。这里的复核是作者对内容负责的一部分,也不能被一次成功预览替代。
用本站完成可视与代码的交叉核对
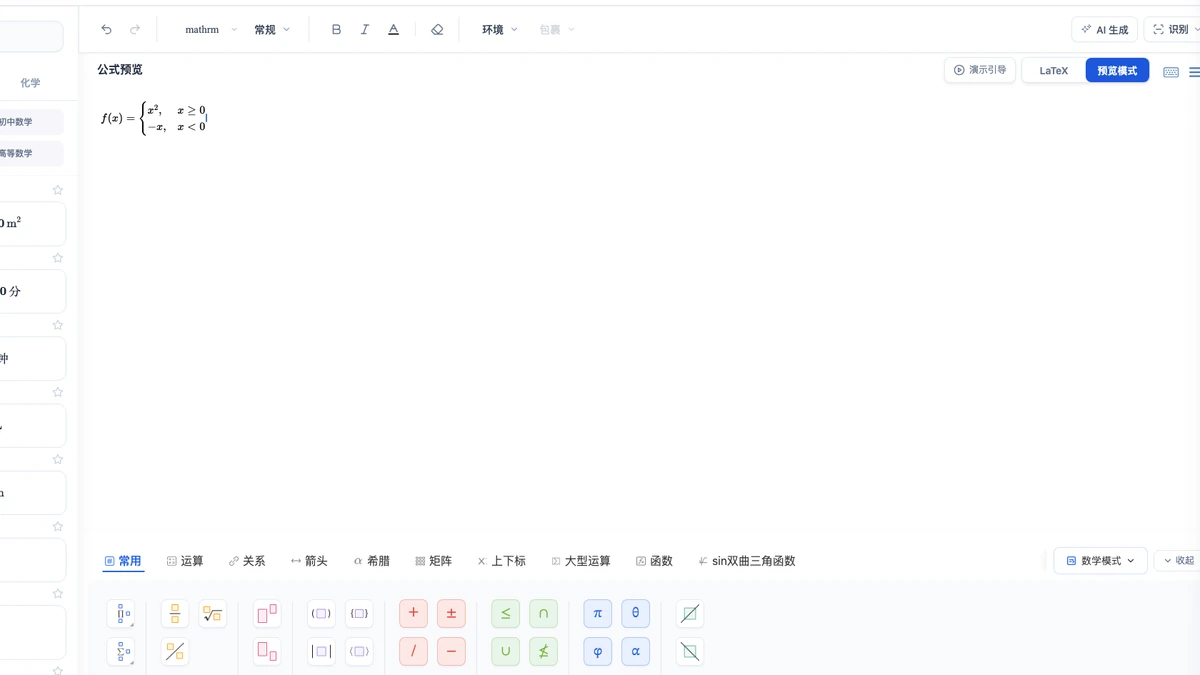
本站公式编辑器提供「可视化」和 LaTeX 两种模式,可用来观察同一表达式的布局与源码。处理矩阵时先核对显示的行列,再检查代码所表达的分隔关系;处理分式时则逐层对照参数范围。模式切换方便观察,数学含义仍以你核实后的原稿为准。
图片识别和公式导出需要登录及会员权益。识别取得的结果应先校正结构,再选择后续文档所需形式;导出前要回到「可视化」。原图中的坐标记录与符号解释可以保留在自己的笔记里,遇到后续疑问时能直接定位到具体行列或变量。
延伸阅读
- 公式 OCR:查看公式识别工作的基本边界。
- 公式OCR识别:按字符错误与结构错误分别排查。
常见问题
- 数学OCR为什么不能只看字符是否正确?
- 数学含义还取决于字符的相对位置和上下文。矩阵里的数换一列、指数依附到另一个对象,即使字形没有变化,也可能改变整个表达式的意义。