公式OCR识别:字符读取与结构还原的区别
更新于
公式OCR识别后,有时所有字母都对,整条式子仍然不能用。这是因为读取字符与恢复数学结构是两件事:前者要判断图上写了什么,后者要判断这些内容怎样组合。理解这个差别,能帮助你在输出异常时找到该改的部分,而不是反复换一张几乎相同的图片。
看见字母还不等于知道它属于哪里
普通段落通常按行阅读,公式却常把信息放在主行的上方、下方和括号内部。数字二出现在变量右上方时可能是指数,出现在同一高度时则可能是相乘的数或名称的一部分。只保留字符顺序,往往无法保留这种区别。
分式更加明显。分子与分母分别占一块区域,中间的线不是普通标点,而是把两块内容组织起来的结构线。若识别结果将它们排成连续一行,即使每个字符都认出来,也需要重新确定除法范围。把输出的字母全部核对一遍,不能替代这一步。
准备素材时应保留这些结构提示。裁切只考虑字的外框,可能截掉根号横线尾部或括号尖端;压缩图片则可能让细分数线断开。此时应改善输入或回看更完整的来源,不宜仅凭结果“像一条公式”就继续使用。
把失败结果分为字形错与分组错
字形错误通常能指出具体替换位置,比如一个数字被读成相近字母。可以对照原图修改,再复查邻近的小标记。若同一位置反复看不清,原因可能在素材本身,应先获取更清楚的局部,而不是让多个不确定结果互相投票。
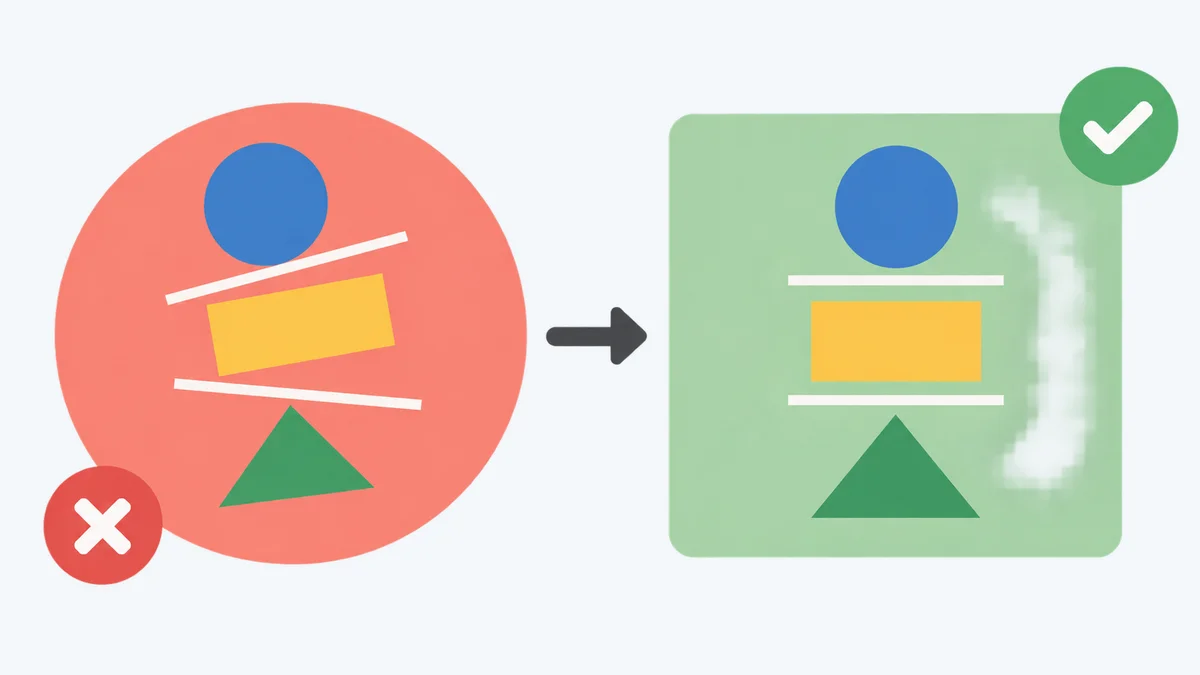
分组错误则需要调整关系。分母少包含了一项、平方没有作用于整个括号、下标的加一跑回主行,都属于这一类。处理时先找到外层结构,再向里检查,不要只移动视觉上的空格来让它“看起来接近”。空格可以改变间距,却不一定改变数学结构。
实践中两类问题会一起出现。建议先记录原图应有的层级,再逐项核对字形,这样不会在改完十几个字符后才发现整块内容放错了位置。若来源包含正文和多条公式,先确定每条的范围也很关键,否则结果可能从一开始就混入了相邻内容。
用一个指数例子验证理解是否一致
原图如果表达整个和的平方,结果应保留外层括号:
(a+b)^2
若变成下式,字母、数字和加号都还存在,运算对象却已经变化:
a+b^2
因此复核时可以直接问“平方的是哪一块”,而不是问“有没有数字二”。对根号可以问覆盖哪几项,对求和可以问上下限依附于哪个运算符。把问题落到作用对象上,往往比单纯比外观更有帮助。
检查还应包含原文语境。有些编号和注释看起来也像脚标或括号,是否属于公式需要结合页面位置与文字说明。无法从图片确认的地方要暂留疑问,不能把自动输出当成原作者含义的证明。
在编辑器中修正对应层级
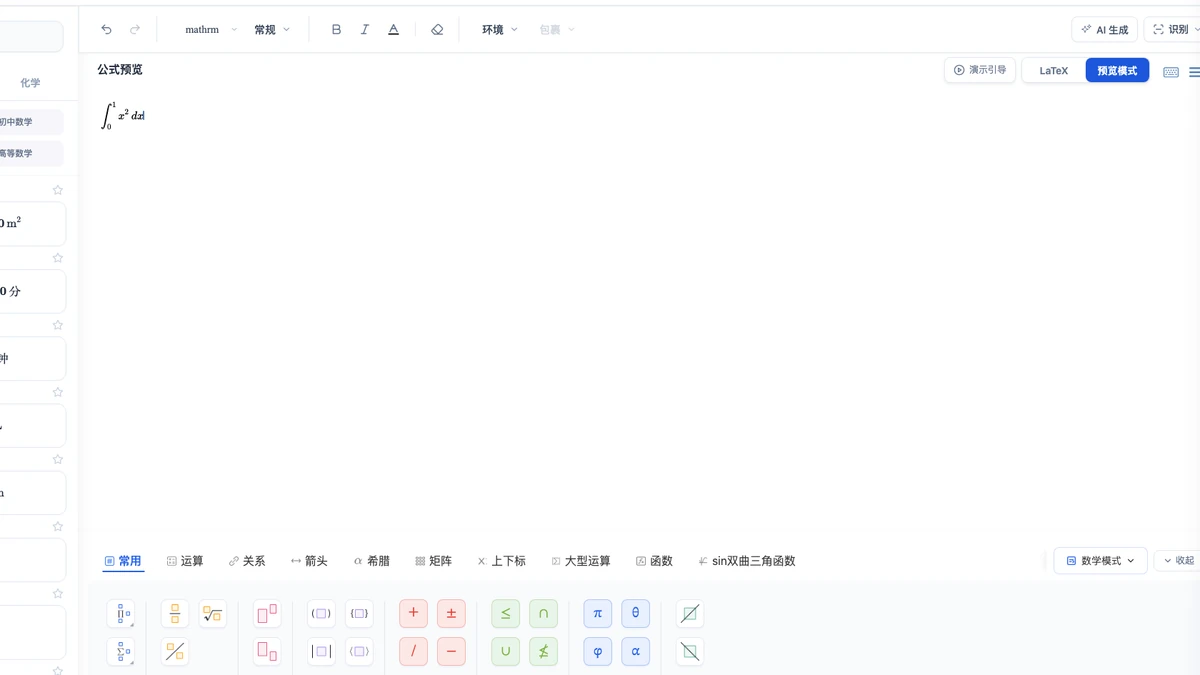
本站的图片识别可将结果插入公式编辑器,识别使用要求为登录与会员。之后可以用预览观察分组效果,再在 LaTeX 模式查看结构表达。若仅有一处错误,应定位到对应字符或参数修订,改后再从整式看一次范围关系。
准备带出结果时,先回到「可视化」,并核对目标格式。导出需要登录和会员;目标文件打开后也应复查复杂结构。这样把输入、结构修订与交付检查衔接起来,才不会把一段能显示的内容误当作已经核实的公式。
延伸阅读
- 公式 OCR:理解公式处理与普通文字读取的差异。
- 数学OCR:继续检查空间布局背后的符号含义。
常见问题
- 公式OCR识别和文字识别有什么不同?
- 除了辨认字母和数字,还需要恢复它们在分式、上下标和括号中的位置关系。字符相同但层级不同会表达不同含义,因此结果应结合原图检查结构。