回归方程公式识别:帽子β̂、误差项与下标的校对
更新于
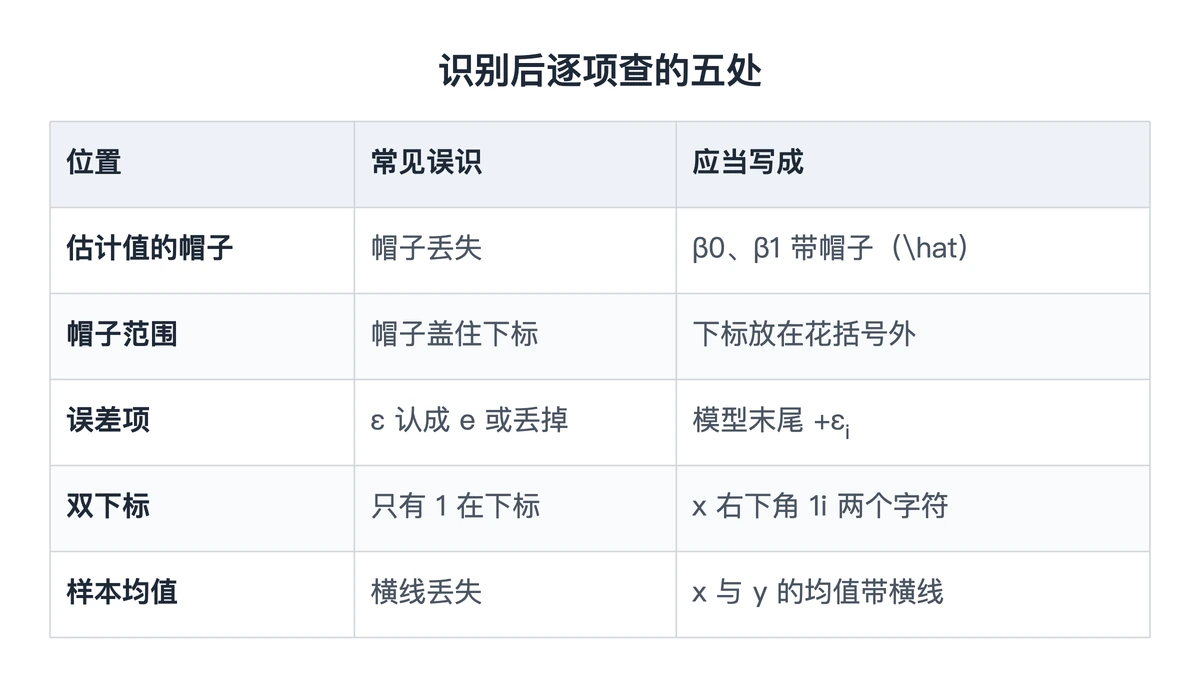
回归方程公式识别最容易出错的是三处:估计值头上的帽子 β̂ 是丢了还是盖错了范围,误差项 εᵢ 有没有被认成字母 e 或整个漏掉,双下标 x₁ᵢ 的两个字符是不是都在下标里。这三处在预览里看着都像对的,却会把「总体参数」和「样本估计」混在一起。总体模型和估计方程各有一处容易丢的符号,先认清两者的差别。
适用场景与准备
作业里要引用教材的回归模型、论文里要照搬别人的估计方程、复习时把讲义上的推导整理成电子版,都属于这类。回归式子的难点在「小东西多」:帽子只有字母的一半宽,下标里常常是两个字符,截图时稍微缩小就会糊掉。
截图前把讲义或 PDF 放大到帽子和下标都清楚,只框一条式子,式子后面的编号 (2.1) 留在框外。图片识别支持 PNG、JPG、BMP、WEBP、GIF,单张不超过 20MB(上传前会压到 10MB 以内),一次一张,格式与大小以上传区下方提示为准,需要登录并开通本站会员。
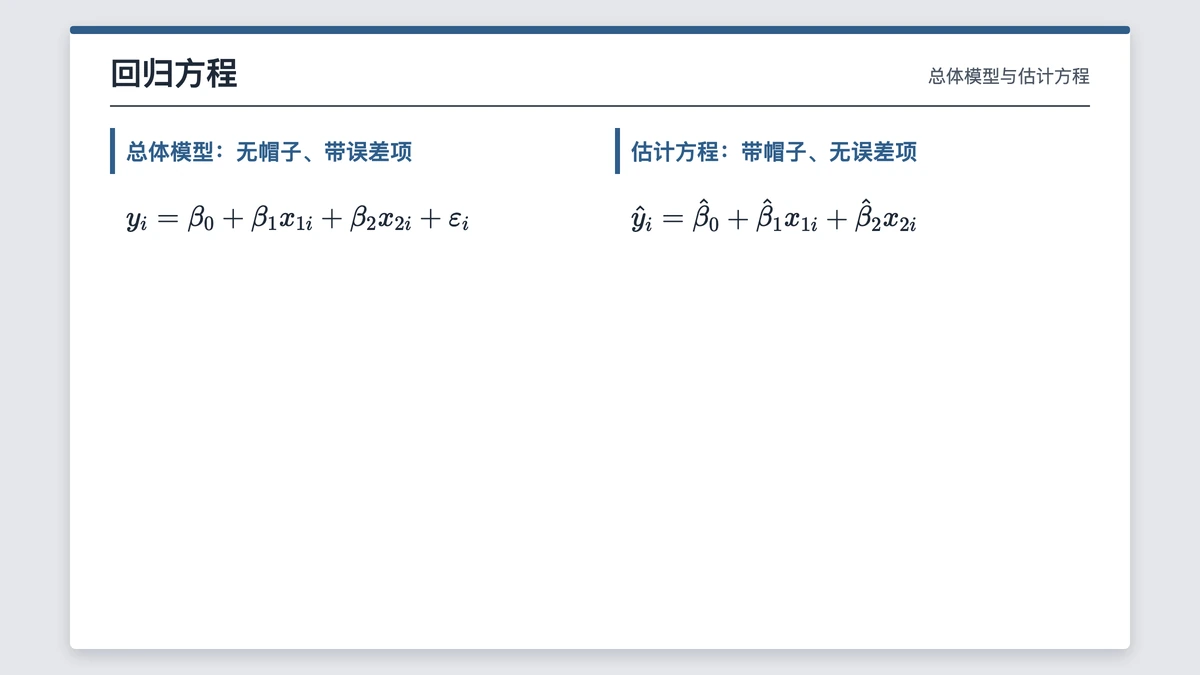
先看总体模型,它描述的是理论关系,参数不带帽子,末尾有误差项:
y_i=\beta_0+\beta_1x_{1i}+\beta_2x_{2i}+\varepsilon_i
操作步骤:截图识别并打开源码
- 在公式编辑页点「识别」→「图片识别」,打开「图片公式识别」弹窗。
- 按 Ctrl+V(Mac 上 ⌘V)粘贴截图,识别直接开始;从文件夹点选或拖入的图片,要再点「开始识别」。
- 识别后先出结果卡片,点「插入」公式才插到编辑区光标处。把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」看源码,对照原图逐项看。
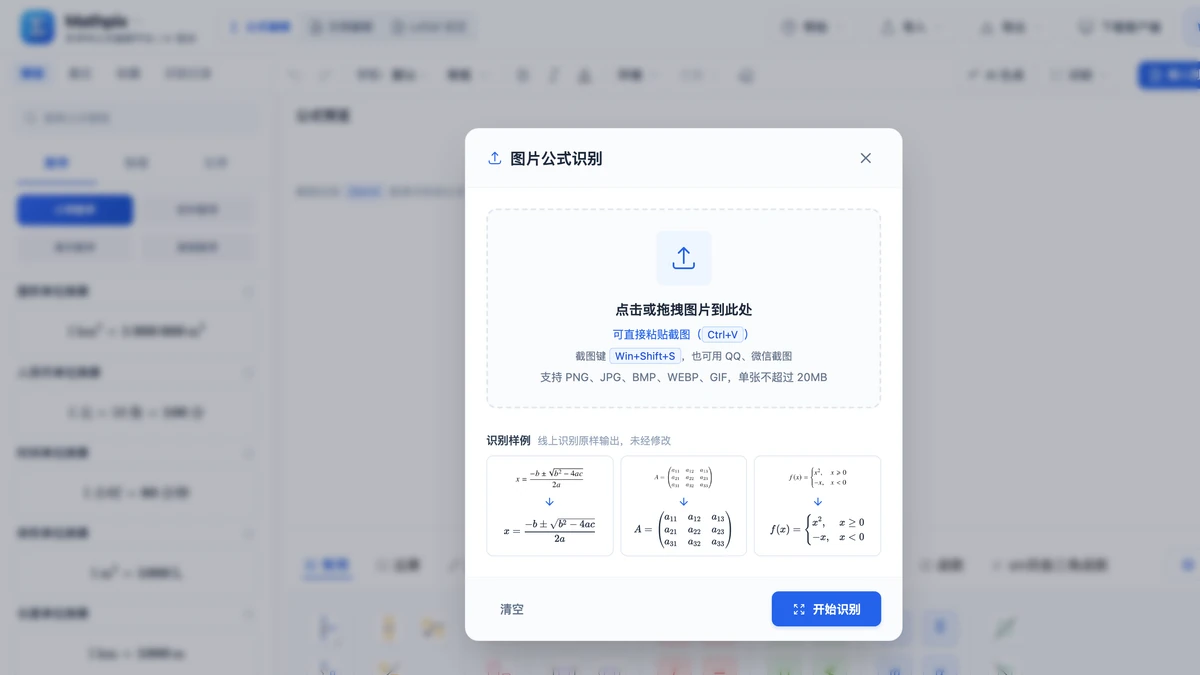
弹窗上传区下方的「识别样例」列了几组原图和线上识别的原样结果,可以先看一眼效果。
校对三处:帽子、误差项、下标
一、帽子盖的是谁。 估计出来的回归直线要带帽子:
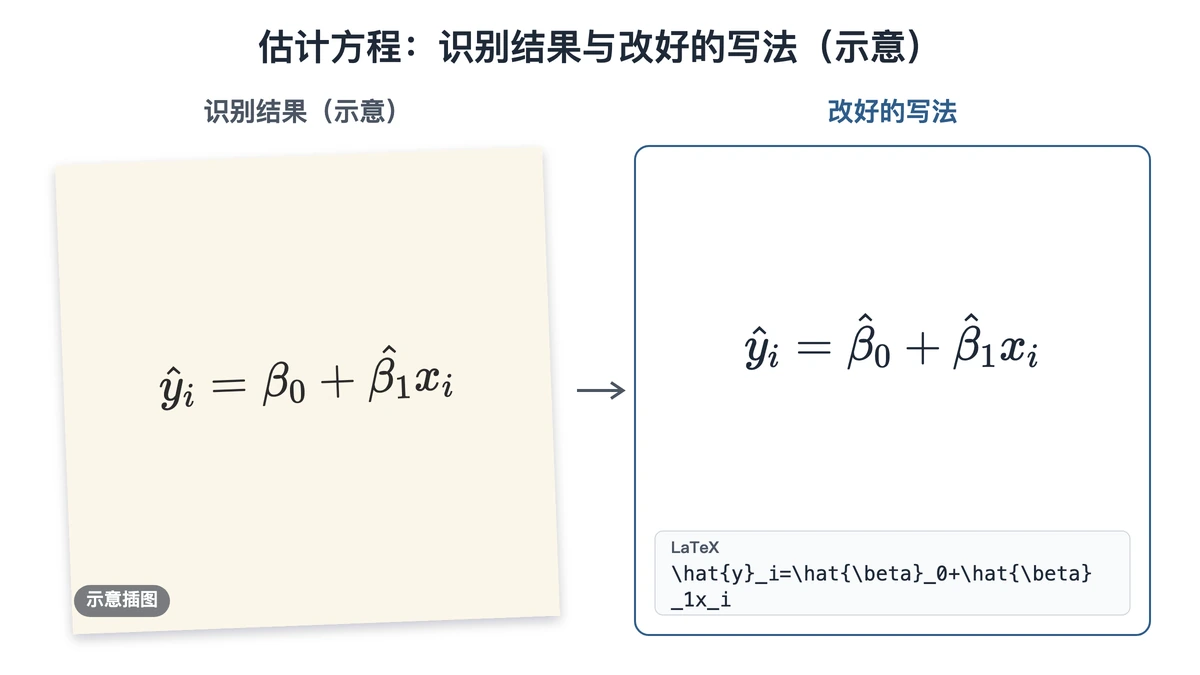
\hat{y}_i=\hat{\beta}_0+\hat{\beta}_1x_i
源码里应当是 \hat{\beta}_0,下标在花括号外面。常见的错有两种:帽子整个丢了,写成 \beta_0,意思从「估计值」变成「真实参数」;或者写成 \hat{\beta_0},帽子把下标也盖住,排出来帽子偏右。下图左边把这两种错放在一条式子里(示意),右边是改好的写法。
二、误差项和残差别混。 总体模型末尾是希腊字母 ε(源码 \varepsilon_i 或 \epsilon_i,两种写法字形不同,全文统一一种);估计之后的残差通常写拉丁字母 eᵢ = yᵢ − ŷᵢ。识别结果把 ε 认成 e,或者把末尾的 +εᵢ 整个丢掉,模型就从「有随机误差」变成了「精确等式」。
三、双下标要包在一起。 x₁ᵢ 表示第 1 个解释变量的第 i 个观测,源码必须是 x_{1i}。写成 x_1i 时只有 1 在下标,i 掉回基线,变成 x₁ 乘 i。
最小二乘的斜率估计式里还有两处要看:求和号上下限 i = 1 到 n,以及分子分母里的样本均值 x̄、ȳ 的横线不能丢。
\hat{\beta}_1=\frac{\sum_{i=1}^{n}(x_i-\bar{x})(y_i-\bar{y})}{\sum_{i=1}^{n}(x_i-\bar{x})^2}
做完之后用一组小数据验算
结构查完,拿三组观测把式子代一遍:x = 1、2、3,y = 2、4、5。均值 x̄ = 2、ȳ = 11/3,斜率式的分子是 3、分母是 2,得 β̂₁ = 1.5,再由 β̂₀ = ȳ − β̂₁x̄ 得 β̂₀ = 2/3。三个残差是 −1/6、1/3、−1/6,加起来是 0;再乘上各自的 x 相加,−1/6×1 + 1/3×2 − 1/6×3 = 0,这两条都是最小二乘的性质。第二条不为 0,多半是斜率式分子分母里某个括号或横线出了错。
核对无误,把公式工具栏右端的「LaTeX / 可视化」开关切回「可视化」,再从顶栏「导出」选需要的格式。原图本身糊的,先看低清扫描公式识别;上下标位置吃不准的,对照截图公式上下标识别。
讲义上下一条要整理的,如果是带交互项或对数的模型,照样先数一遍帽子、再看 ε,最后查每个双下标。
延伸阅读
常见问题
- 帽子只盖一个字母怎么写?
- 单个字母用 hat 命令加花括号,比如贝塔的估计值就是 hat 后面花括号里写 beta,下标放在花括号外面,这样帽子只盖住贝塔、不盖下标。要让帽子横跨两三个字母,改用 widehat。识别结果里帽子把下标也包进去的,把下标挪到花括号外即可。