通义千问识别公式图片:步骤与校对
更新于
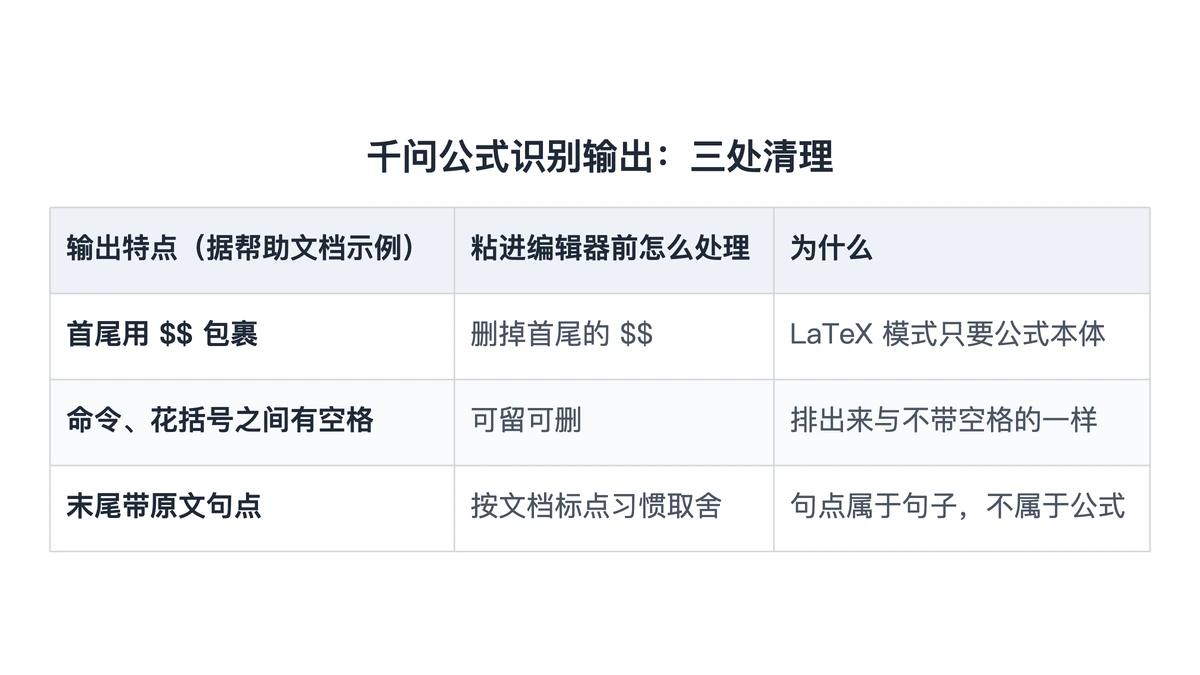
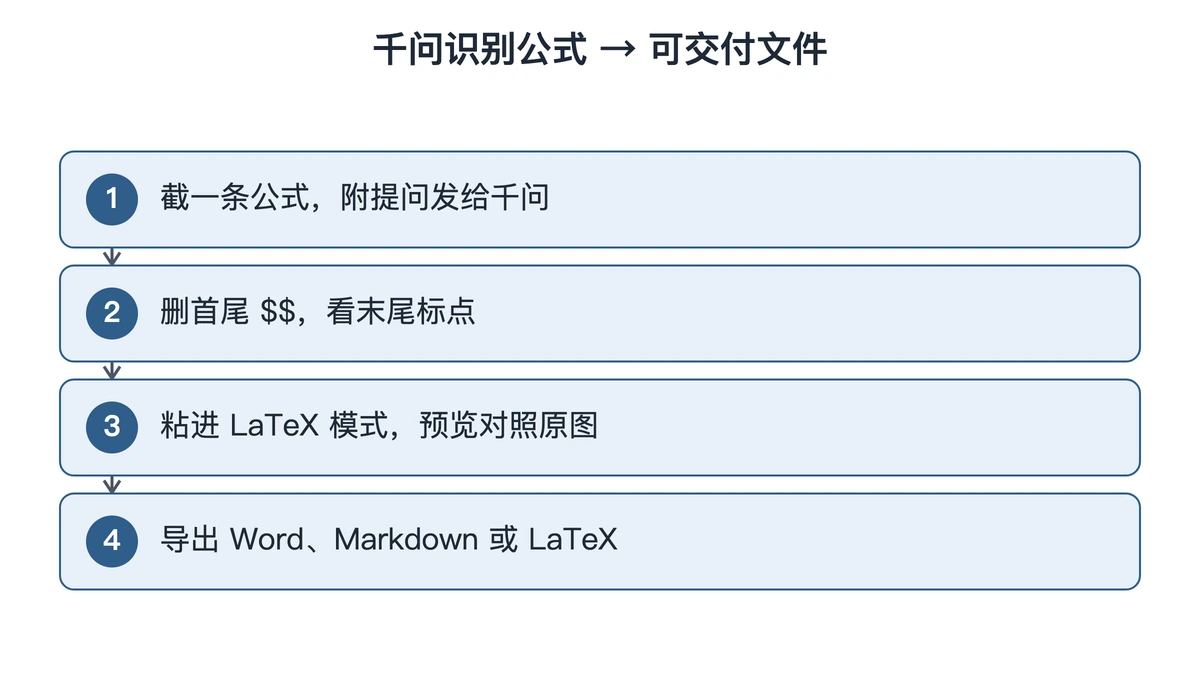
用千问识别公式,要的是一段能直接渲染的 LaTeX:上传只含一条公式的截图,要求它只输出源码;拿到结果后先去掉首尾的定界符,再粘进本站编辑器的「LaTeX」模式,渲染出来和原图逐项对照。阿里云百炼的帮助文档「文字提取(Qwen-OCR)」(2026 年 9 月 26 日查阅)写明,千问的 OCR 模型内置「公式识别」任务,给出的示例输出用 $$ 包裹、命令和花括号之间隔着空格,末尾还带着原文的句点。这三个特点,正好是转格式前要清理的三处。
两个入口与准备
千问识别公式有两个入口:
- 千问对话。 在对话框里上传截图,附一句提问,界面以当前版本为准。
- Qwen-OCR 模型。 上面那份帮助文档说明,这组模型把公式识别做成了内置任务(任务名 formula_recognition),可以在百炼控制台的视觉模型体验页里在线试用,也能用接口调用;文档列出的输入格式包括 JPEG、PNG、WebP。
两种入口的准备一样:一张图只截一条公式,式号和前后文字裁掉,把页面放大到上下标看得清再截。多行推导按行拆开,一行一张。
提问可以照下面这句写,和截图一起发:
请把图片里的公式转写成 LaTeX 源码,只输出源码本身,不要解释,不要加美元符号或代码块标记,原图怎么写就怎么转。
从回答到可用源码:三处清理
帮助文档里公式识别的示例输出是这样一段(原样照录):
$$\tilde { Q } ( x ) : = \frac { 2 } { \pi } \Omega , \tilde { T } : = T , \tilde { H } = \tilde { h } T , \tilde { h } = \frac { 1 } { m } \sum _ { j = 1 } ^ { m } w _ { j } - z _ { 1 } .$$
拿到类似的结果,按这个顺序处理:
- 删掉首尾的
$$。 编辑器的 LaTeX 模式只要公式本体;要带定界符的场合,导出 Markdown 时再选行内或独立成行。 - 空格可以留着。
\frac { 2 } { \pi }与\frac{2}{\pi}排出来完全一样;想让源码好读,可以顺手删掉,但别删到\cos nt这类命令和字母之间必须有的空格。 - 看末尾的标点。 示例最后的句点来自原文句子,放进 Word 里单独成行的公式时,按你文档的标点习惯决定留不留。
粘进编辑器对照原图
以向量余弦相似度为例,清理后的源码是:
\cos\theta=\frac{\sum_{i=1}^{n}a_{i}b_{i}}{\sqrt{\sum_{i=1}^{n}a_{i}^{2}}\sqrt{\sum_{i=1}^{n}b_{i}^{2}}}
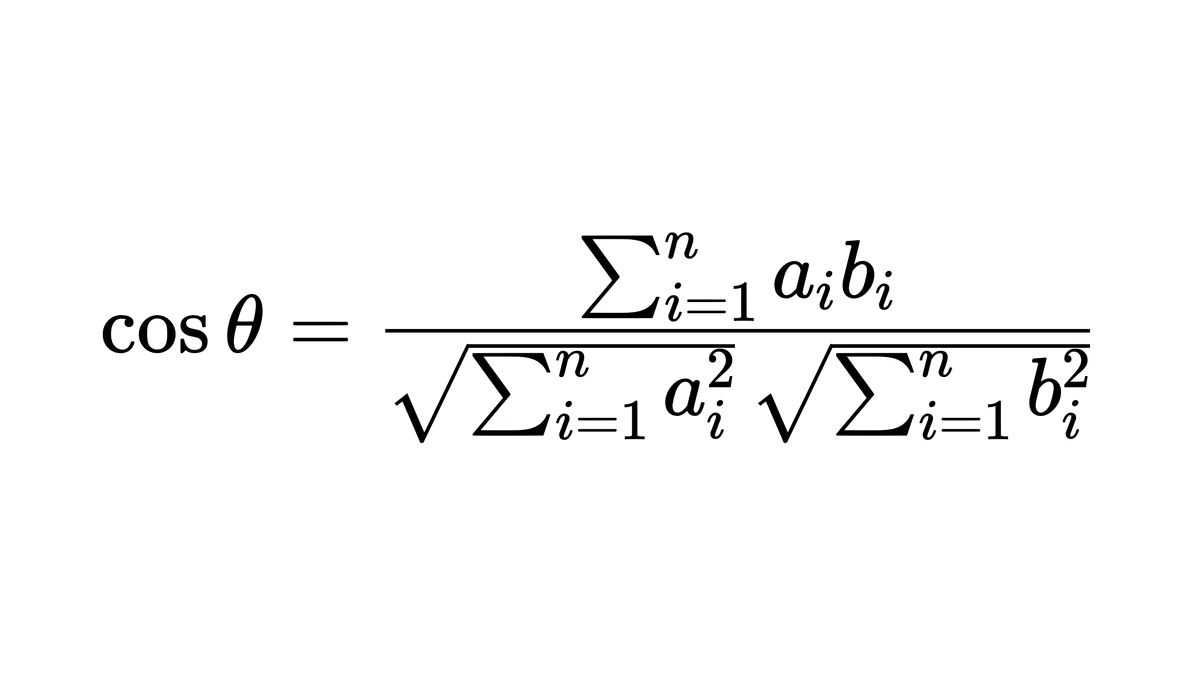
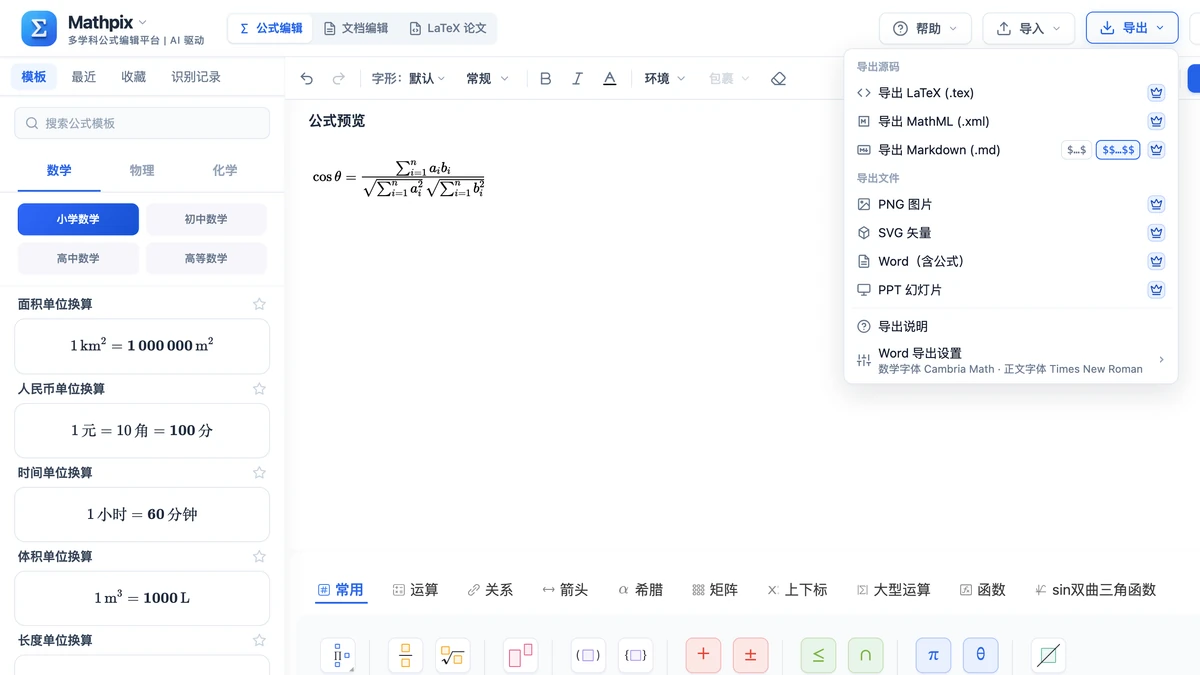
- 打开本站公式编辑页,把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」,把源码粘进去;公式编辑和预览免费且不用登录。
- 点「可视化」,把渲染结果和原图并排看。
- 确认无误后从顶栏「导出」选格式:「Word(含公式)」得到这一条的 Word 原生公式,「导出 Markdown (.md)」可选行内
$…$或独立$$…$$,「导出 LaTeX (.tex)」保存源码。导出要登录并开通本站会员。
也可以不经过对话:在公式编辑页点「识别」→「图片识别」,弹窗开着时粘贴截图,识别后先出结果卡片,点「插入」,进编辑区的已经是公式本体(要登录并开通本站会员)。
转换后要检查的三处
- 分母里的两个根号。 余弦相似度的分母是两个根号相乘,识别时容易合成一个根号、或者把平方挪到根号外面。预览里看根号横线的长度,两段各管一个求和。
- 下标和上标的位置。 aᵢ² 的 i 在右下、2 在右上;识别结果写成
a^{2}_{i}或a_{i}^{2}都对,写成a_{i^{2}}就错了。 - 求和的上下限。 三个 Σ 的上下限都应当是 i=1 到 n,逐个看,漏掉一个就改一个。
识别前想确认账号状态,看公式识别登录限制;识别额度要连同计量口径一起看,见在线公式识别额度。
下次千问给回一段带 $$ 和满屏空格的源码,先删定界符、看末尾标点,再粘进 LaTeX 模式渲染一遍,对上原图就可以导出。
延伸阅读
常见问题
- 千问能一次识别多张图吗?
- 对话里一次能传几张图,以千问当前版本的界面为准。做公式识别时建议一次只问一张、一张只含一条公式:几条公式混在一张图或一次回答里,结果对不上原图时很难定位是哪一条出错。多条公式分几轮问完,每拿到一条源码就在编辑器里渲染对照一次,最后在文档编辑里逐条插入、一起导出成 Word 文档。