PDF图片层公式提取:先判断页面类型
更新于
PDF图片层公式提取之前,先做一个小测试:页面看起来像排版整齐的论文,里面的公式是否真的能作为文字取得?有些文件整页都是扫描图,有些正文可选而公式是图片,还有些扫描页附带识别文字。不同情况要分别判断,不能凭扩展名决定提取方式。
用选择和粘贴测试公式所在的区域
在 PDF 阅读器里选取一小段正文,复制到空白的纯文本区域,看文字是否与页面一致。再单独对一条公式做同样测试。如果正文能正常取得,而公式只能选中整个图块或没有字符,说明不能沿用正文的处理路线。
选择失败也不必直接断定整份文件都是图片,还可能与阅读器当前工具或文档设置有关。确认使用文字选择方式后,再换页面中另一处测试。目的不是给整个文件贴标签,而是确定当前要摘取的公式能不能获得可靠内容。
扫描页即使存在可选文字,也可能只是后来附加的识别结果。粘贴出来的字符若与视觉内容不同,应以原页为参照。公式的二维层级尤其不能由一串可复制文字代替,分式、上下标和矩阵需要另查结构。
完成测试后,给本次材料做简短记录:正文取文字,某几条公式取图,哪几处仍需查证。一本资料中可以混合多种页面类型,逐页抽查比在第一页测试成功后套用整本更稳妥。
从原页保存两份不同用途的参照
一份保留整页或完整上下文,用来记录页码、公式编号和变量说明;另一份只框目标公式,用作图片识别输入。这样可以减少识别区域中的杂项,又不丢失理解公式所需的资料。两份文件用相同来源编号关联。
框取时检查四个方向:左边的正负号、右边的括号、上方指数和下方条件。若是分段函数,所有分支都属于同一个对象;若旁边附有独立说明,把说明记到文字记录中。不要为避开正文而把公式本身截成不完整片段。
在阅读器中调整到能看清细字符的大小,再保存截图。页面本就模糊时,扩大显示不会恢复缺失笔画,应另找清楚来源。截图得到后重新打开查看,确认保存过程没有把小字压缩得难辨,也没有把页码混入数学区域。
将局部图片转为可核对的公式
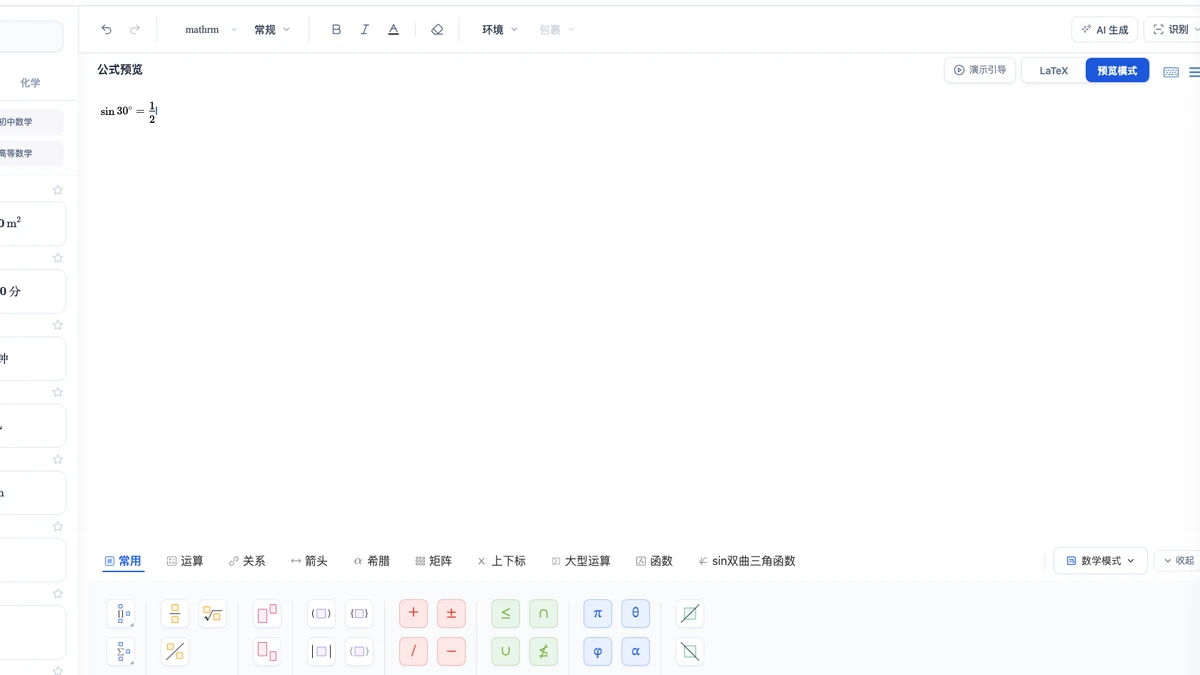
本站图片识别可接收 PNG、JPG、BMP,单张上限为 5MB,提交需要登录并开通会员。这里处理的是准备好的区域图片,不应把它理解为整本 PDF 的自动整理。逐条处理后,在编辑区比对原图中的符号和层级。
先查看结果是否混进编号,再核对分子分母范围和所有上下标。对两条相似的连续公式,用来源编号确认顺序,不能仅凭它们长得相近就随意归位。发现图像边缘缺损时,应重截完整区域,而不是直接给结果补上想象中的字符。
导出的成品也要能回到原页
需要继续编辑时,可按目标选择相应输出。例如交到 Word 中,用 .docx 路线,并在 Word 2016 及以上打开后实际检查公式对象;需要源码,则在核对后带走 LaTeX 文件。本站导出要切回预览模式,且需登录及会员。
导出后的文件名或个人整理清单中保留来源页码,正式文稿里的引用信息按实际材料处理。再打开成品,对照原页查一遍结构,确保没有在汇总时接错条目。保留原 PDF 的意义在于可追溯,不能让一组孤立截图成为以后判断内容的全部依据。
延伸阅读
常见问题
- PDF图片层公式提取前怎么判断页面类型?
- 在阅读器中分别尝试选择正文和公式,再把选中内容粘贴到纯文本中比较。能选中正文不代表公式也有可靠文字内容,带识别文字层的扫描页仍需看原图。
- PDF图片层公式提取为什么建议只框公式区域?
- 局部框选有助于减少页码、正文和邻近图注混入,同时保留完整公式的空间关系。上下标、分式和分段条件必须包含在框内,并留下来源页码供复核。