论文公式复现:从论文截图识别到代码核对
更新于
论文公式复现可以分三步:把论文里的公式截图识别成 LaTeX,对照论文的记号说明逐个核对符号,再照着核对过的源码写代码,并用一组小数值检验代码的输出。容易出错的是第二步:同一个上标,可能是幂次,也可能是时间步序号;同一个平方,可能是逐元素运算。字形识别得再准,这层含义也只能从论文的文字里找。截图识别要登录并开通本站会员,写代码和核对数值在你自己的环境里做,具体记号以原论文和你所在学校或期刊的要求为准。
结论先行:识别管字形,含义看论文
下面用 Adam 优化器的原论文(Kingma 与 Ba,arXiv:1412.6980 第 9 版,2017 年 1 月 30 日)演示。它的「算法 1」下方有三句说明,恰好是复现时最容易踩的点:
- gₜ² 表示逐元素平方。 写代码时是对梯度向量每个分量各自平方,而不是向量内积。
- β₁ᵗ、β₂ᵗ 表示 β₁、β₂ 的 t 次方。 这里的上标 t 是幂次,而 mₜ、vₜ 的下标 t 才是时间步。
- 所有向量运算都逐元素进行。 包括除法和开根号。
论文正文还给了一种更省计算的等价写法,里面用的是带帽的 ε̂,它与算法 1 里的 ε 不是同一个量,复现时两种写法别混着抄。
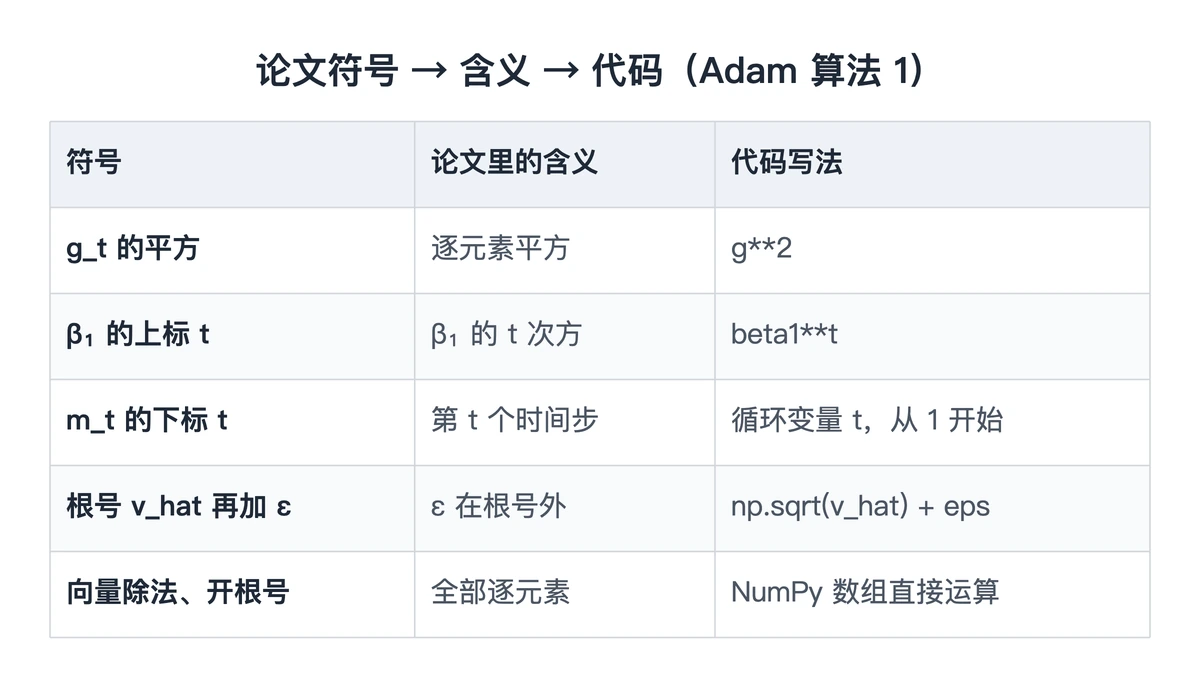
速查表:从符号到代码
截图识别并核对后,偏差修正与参数更新三行的源码是:
\hat{m}_{t}=\frac{m_{t}}{1-\beta_{1}^{t}},\quad\hat{v}_{t}=\frac{v_{t}}{1-\beta_{2}^{t}},\quad\theta_{t}=\theta_{t-1}-\alpha\frac{\hat{m}_{t}}{\sqrt{\hat{v}_{t}}+\epsilon}
对应到代码(NumPy 写法,t 从 1 开始计):
m = beta1 * m + (1 - beta1) * g
v = beta2 * v + (1 - beta2) * g**2        # g_t^2:逐元素平方
m_hat = m / (1 - beta1**t)                # beta1^t:t 次方
v_hat = v / (1 - beta2**t)
theta = theta - alpha * m_hat / (np.sqrt(v_hat) + eps)   # eps 在根号外
源码与代码逐行对照,每个符号在下表里都能找到对应的写法:
例题示范:截图、识别、核对、验算
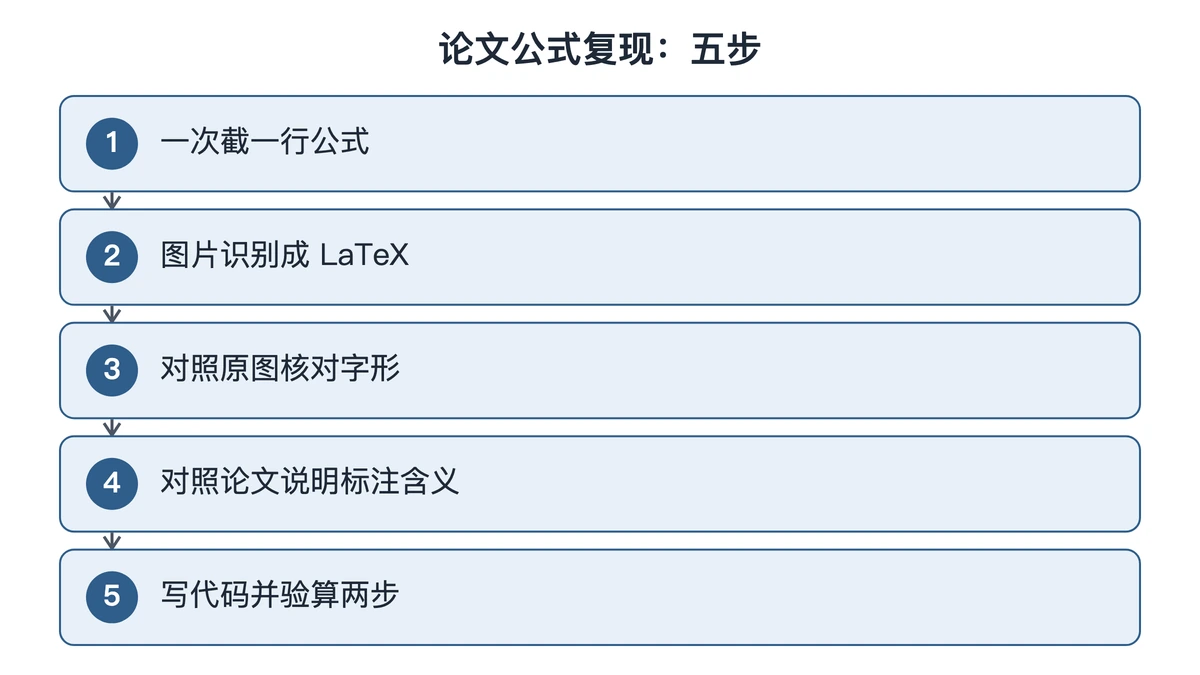
- 截图。 把论文 PDF 放大到上下标清楚,一次只框一行公式,算法框左边的行号、右边的注释都裁掉。
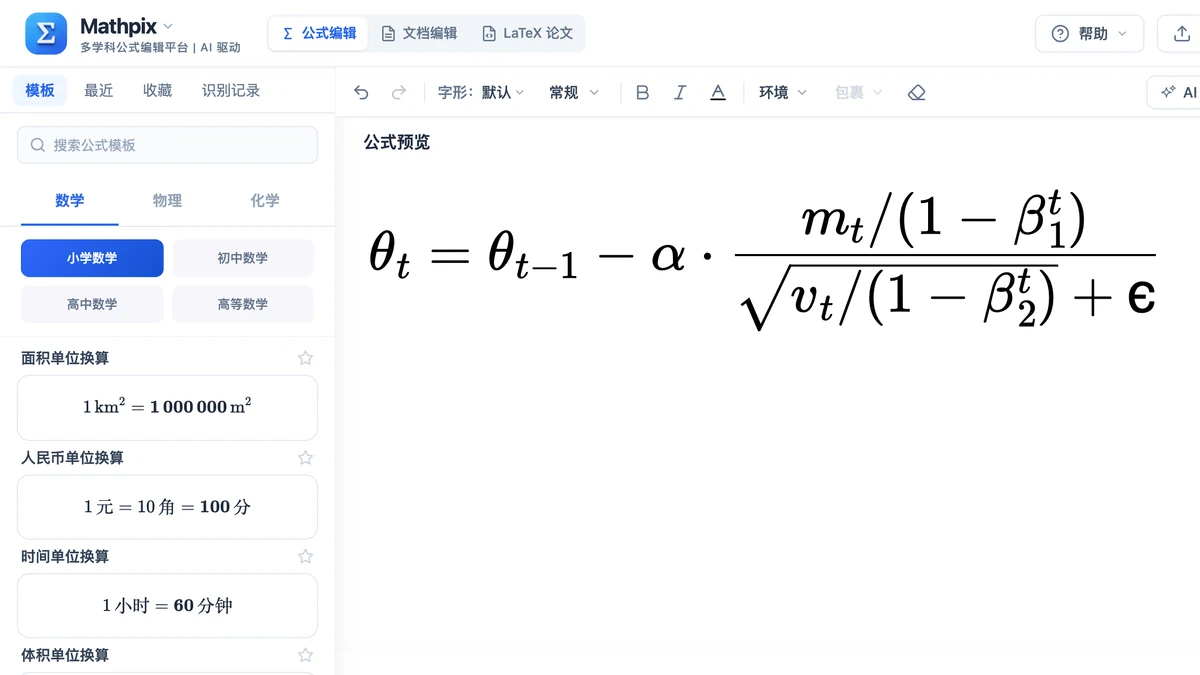
- 识别。 在本站公式编辑页点「识别」→「图片识别」,弹窗开着时按 Ctrl+V(Mac 上 ⌘V)粘贴截图,识别直接开始。
- 核对字形。 切到「LaTeX」,对照原图看 β 的下标 1、2 有没有互换,mₜ 上面的帽子还在不在,ε 在根号里还是根号外。
- 核对含义。 对照论文的说明,给源码里每个上标标上「幂次」或「序号」,给每个平方标上「逐元素」。
- 验算。 取论文给的默认值 α = 0.001、β₁ = 0.9、β₂ = 0.999,设 m₀ = v₀ = 0,梯度连续两步都是 0.2。手算第一步:m₁ = 0.02,修正后 m̂₁ = 0.2;v₁ = 0.00004,修正后 v̂₁ = 0.04,开根号是 0.2,更新量约等于 α。
- 验算第二步。 第二步修正后仍是 m̂₂ = 0.2、v̂₂ = 0.04,更新量还是约等于 α。只验第一步不够:t = 1 时 β₁ᵗ 与 β₁ 乘 t 恰好相等,两种写法要到第二步才分开。
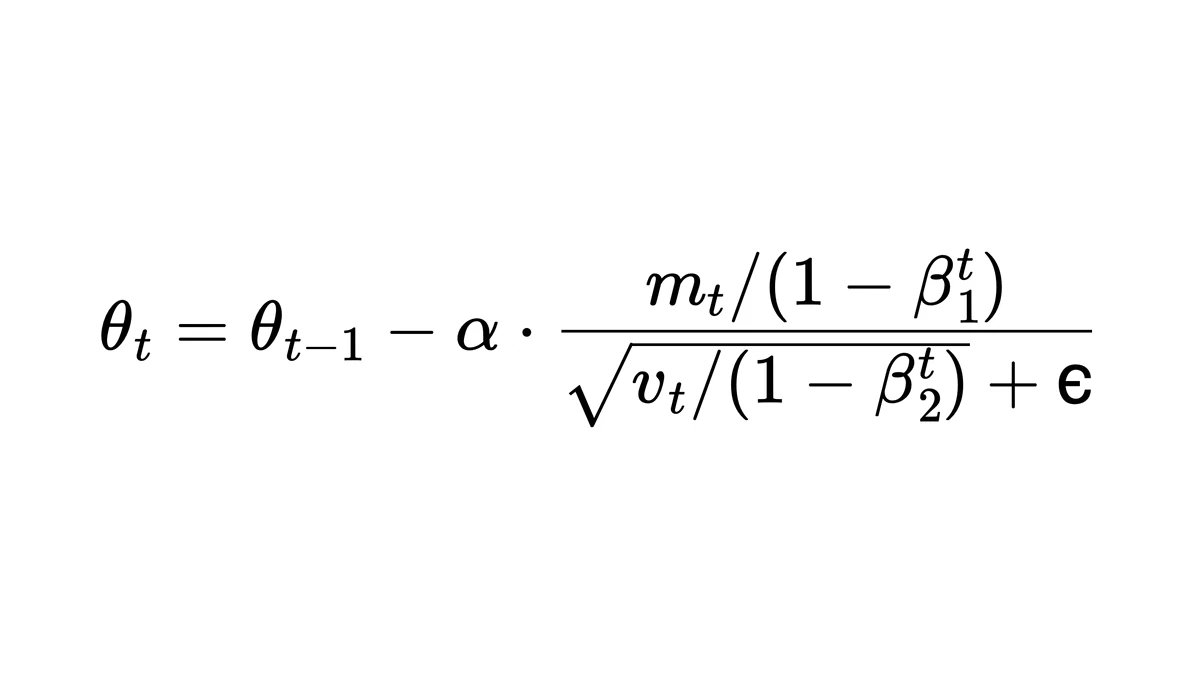
常见错误
- 把幂次当乘法。
beta2**t写成beta2 * t,第二步起 1 − β₂·t 变成负数(t = 2 时为 −0.998),v̂ 为负,开根号得到 NaN。 - ε 放进根号。 识别结果里的根号横线如果盖住了 ε,渲染后很容易看出来;代码里写成
np.sqrt(v_hat + eps)则要靠对照源码才发现。 - 平方写成内积。
g**2与g @ g形状都不一样,后者得到一个数,后续的逐元素除法会被广播,程序照样能跑,结果却错了。 - 两种写法混抄。 从正文等价写法里抄了 ε̂,又用算法 1 的偏差修正,数值会与论文报告的对不上。
截图里上下标看不清的,参照截图公式上下标识别重截;源码复制进笔记前的检查见截图公式转 TeX代码。
手头正在复现的那篇论文,把算法框里每一行截下来识别成源码,存进笔记时在每个上标旁边注明「幂次」或「序号」,写代码就照这份笔记来。
延伸阅读
- 截图公式上下标识别:看清位置再导出
- 截图公式转 TeX代码:复制前先核对这几项
- 论文公式表格转 LaTeX:公式与单元格分开看
常见问题
- 识别的符号和论文定义不一致怎么办?
- 以论文自己的定义为准。识别只负责把图上的字形转成源码,它看不到论文在算法框下方或记号一节里对符号的说明。先在论文里找到那条说明,比如某个平方是逐元素平方、某个上标是幂次而非序号,再决定源码怎么写、代码怎么写。定义与字形冲突时,在笔记里把两者都记下,并注明页码,方便以后回查。