OCR转LaTeX:通用OCR与公式OCR的区别
更新于
OCR转LaTeX要用公式OCR:通用文字识别只输出一行行字符,上标、下标、分式这些靠位置表达的结构会被压平;公式OCR直接输出 LaTeX 源码,结构保留在花括号和命令里。下面拿同一批公式图,把两种识别的真实输出摆在一起,再给出在本站把图片转成 LaTeX、导出成其他格式的步骤。图片识别要登录并开通本站会员。
同一张图,两种OCR各给出什么
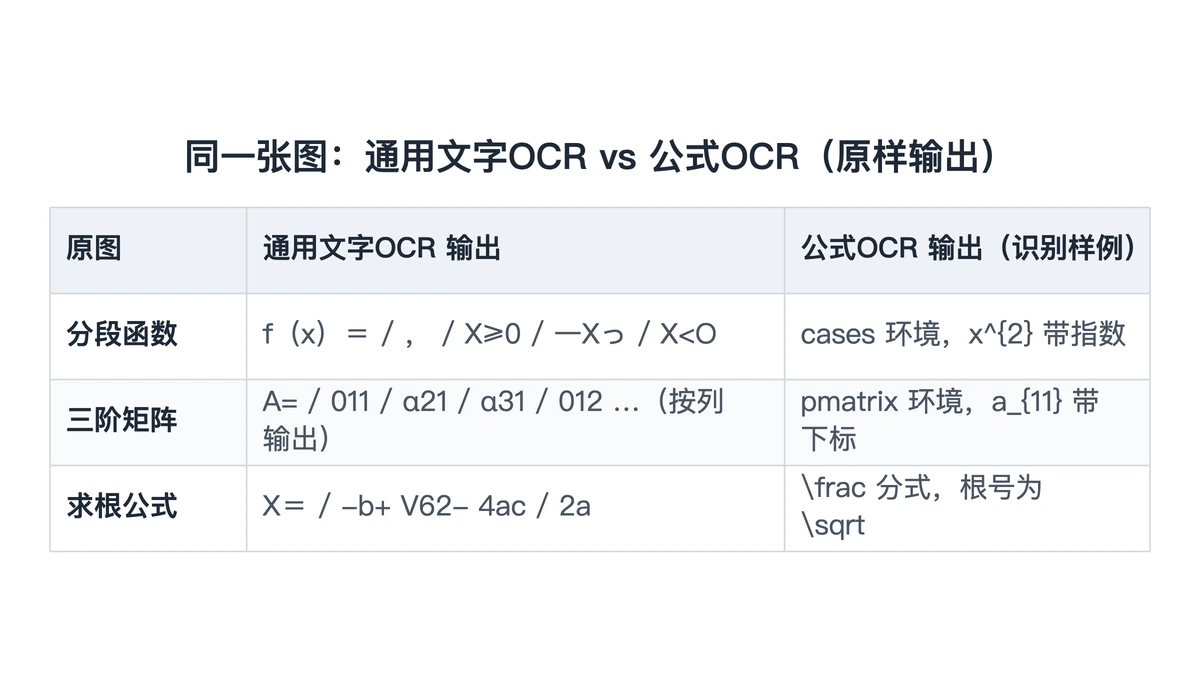
下面拿本站识别弹窗里「识别样例」用的三张原图(分段函数、三阶矩阵、求根公式),先交给 macOS 系统自带的通用文字识别(2026 年 9 月,macOS 27,中英文识别),再和样例里公式识别的原样输出对照:
- 上下标被拉平。 矩阵元素 a₁₁ 出来是 011:字母 a 被认成 0,下标 11 和它排成一排;a₂₁ 成了 α21。分段函数第一行的 x² 没认出来,只剩后面那个逗号「,」。
- 分式拆成两行。 求根公式输出了三行:「X=」、「-b+ V62- 4ac」、「2a」。分数线消失,± 变成 +,根号成了字母 V,b² 被读成 62。
- 多行结构打乱。 三阶矩阵按列吐出:A=、011、α21、α31、012……原来的行列关系要靠人去猜。分段函数的大括号也丢了,-x 被读成「一Xっ」,0 被读成字母 O。
公式识别对同样三张图给出的是完整源码:分段函数是 cases 环境,矩阵是 pmatrix 环境,求根公式是一条 \frac 套 \sqrt 的分式。两者的差别在输出里有没有「结构」这一层,认字准不准倒在其次。
公式OCR转LaTeX:输入与步骤
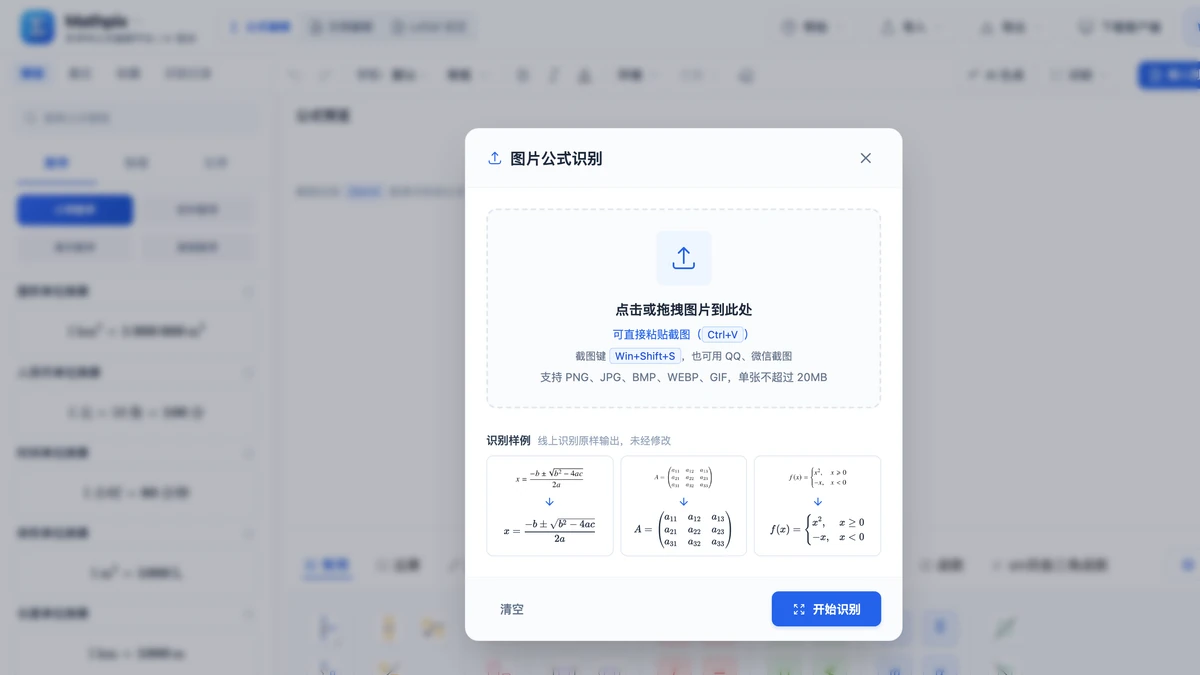
输入来源常见三种:课件或网页截图、手机拍的教材照片、PDF 里截下的一块。格式与大小以上传区下方提示为准,一次识别一张,每张只框一条公式。
- 打开公式编辑页,点工具面板「识别」→「图片识别」。
- 截图在「图片公式识别」弹窗开着时按 Ctrl+V(Mac 上 ⌘V)粘贴,识别直接开始;图片文件点选或拖进上传区后,点「开始识别」。
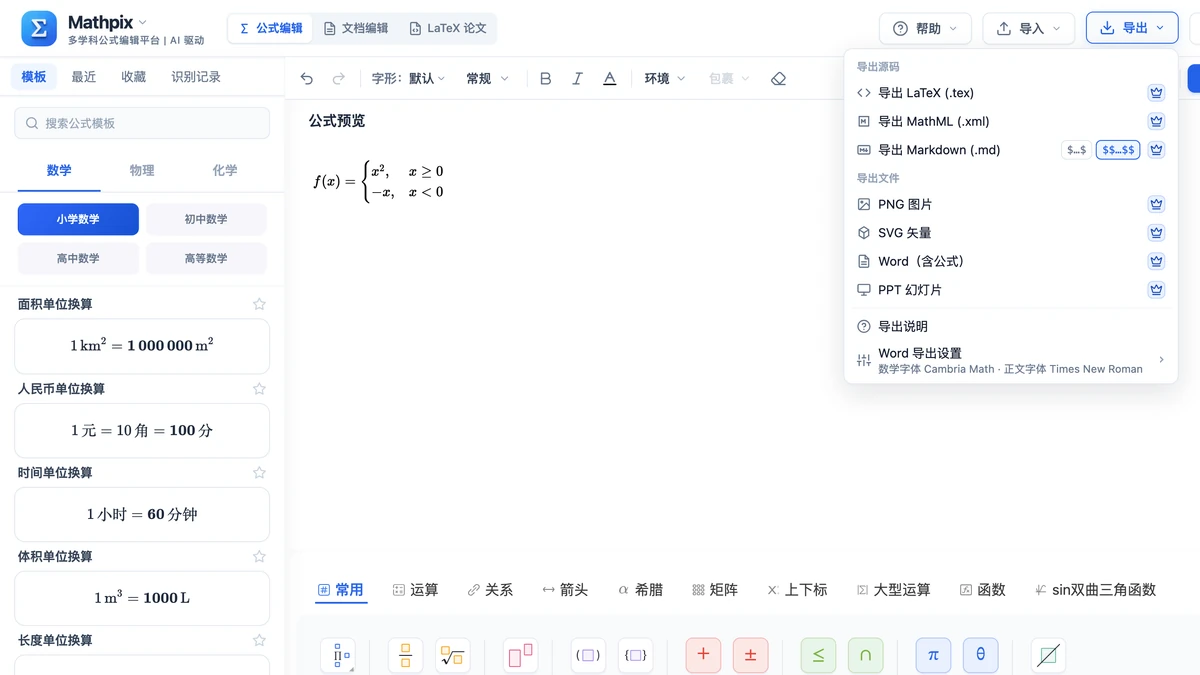
- 在结果卡片点「插入」,公式进入编辑区后,把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」看源码,对照原图改。
- 切回「可视化」模式,从顶栏「导出」选格式:导出 LaTeX (.tex)、导出 MathML (.xml)、PNG 图片、SVG 矢量、Word(含公式)、PPT 幻灯片,或导出 Markdown (.md)。
识别样例里的分段函数源码
弹窗上传区下方的「识别样例」标着「线上识别原样输出,未经修改」,分段函数那一组的源码是:
f(x)=\begin{cases}x^{2},&x\geq0\\-x,&x<0\end{cases}
对照前面通用OCR的结果看:x 的平方在源码里是 x^{2},指数在花括号里;两种情况用 \\ 分行,每行用 & 把表达式和条件隔开。结构都在源码里,换成 Word 公式或 MathML 时结构照样保留。
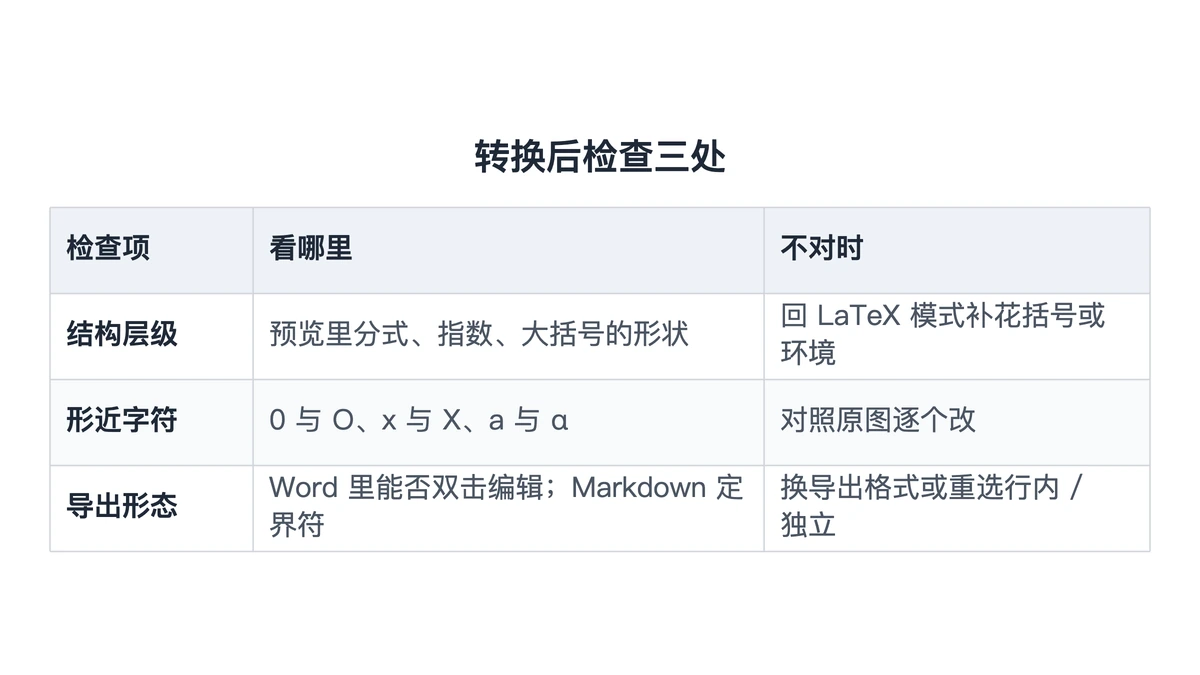
转换后要检查的三处
- 结构层级。 预览里先整体看形状:分式是不是上下排、指数是不是缩小在右上方、大括号有没有包住所有情况。形状对了,再看字符。
- 形近字符。 0 与 O、x 与 X、a 与 α 最容易混,源码里逐个确认;希腊字母应当是
\alpha这类命令。 - 导出后的形态。 Word 里点一下公式,能进入公式编辑就是 Word 原生公式,双击可改;Markdown 里看定界符是行内
$…$还是独立$$…$$,与你导出时选的一致。
通用OCR的结果适合回头检索原文里的文字,公式交给公式OCR。手写稿的结构校对可以看手写转LaTeX,转进 Word 之后的检查见LaTeX转Word公式编辑。
手边那张被通用OCR识别成一串字符的公式截图,直接粘进「图片识别」弹窗,拿回带 cases 环境或 \frac 的源码,对过原图后导出成需要的格式。
延伸阅读
- 手写转LaTeX:校对代码结构的三个层次
- LaTeX转Word公式编辑:转换后先检查哪里
- 论文公式表格转 LaTeX:公式与单元格分开看
常见问题
- 为什么通用OCR识别公式是乱的?
- 通用文字识别的任务是把图片切成一行一行的字符串,它只记录字是什么,位置信息在输出时被丢掉了。下标被拉回基线,分子分母被拆成上下两行,根号被当成字母 V,括号里的多行内容按列吐出。公式的意思恰恰靠这些位置来表达,所以得到的是一串字符,拼不回原来的结构。要拿到能编辑的公式,得用专门识别公式、直接输出 LaTeX 的工具。