中文公式识别:\text包裹与字体处理
更新于
中文公式识别之后,要做的一件事是把公式里的汉字统一用 \text{…} 包起来。本站编辑器里直接写汉字也能显示,看不出问题;可一旦把这条公式放进 ctexart 文档用 XeLaTeX 编译,没包的汉字和写在 \mathrm{…} 里的汉字都会整个消失,只有 \text 包着的留得住。导出到 Word 时,公式里的中文统一用宋体,没有单独的中文字体选项。
识别结果里的中文长什么样
物理、化学和经济类公式常带中文,比如机械效率的下标「有用」「总」,化学方程式上方的「点燃」「高温」,经济学里的「成本」「利润」。这类公式识别出来,汉字可能有几种写法:包在 \text{…} 里、直接写在公式里,或者包在 \mathrm{…} 里。三种在本站编辑器里都不报错。
规范的写法是用 \text 包裹:
\eta=\frac{W_{\text{有用}}}{W_{\text{总}}}
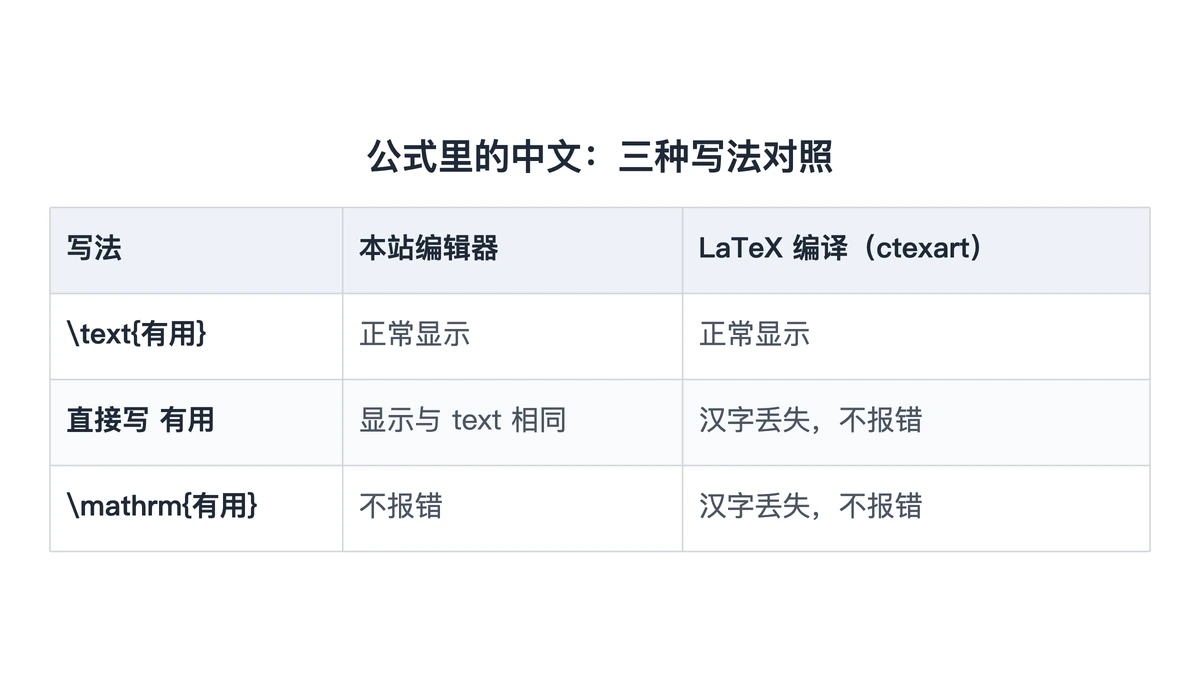
同一条公式,下标里的汉字包 \text 与不包、直接写在公式里,这两种写法在本站编辑器里排出来完全一样。所以只看编辑器的预览,分辨不出哪种写法有隐患,问题要到别的环境里才暴露。
为什么要统一用 text 命令:LaTeX 编译的结果
把三种写法放进同一份 ctexart 文档,用 XeLaTeX 编译:\text 包裹的「有用」「总」正常显示;直接写的和 \mathrm 里的汉字全部没了,下标只剩一个空的 W,编译日志里是一串 Missing character 警告,文档照样编译成功,不报错。
这就是这类问题难发现的原因:不报错,PDF 也生成了,只有逐行看才会发现下标是空的。
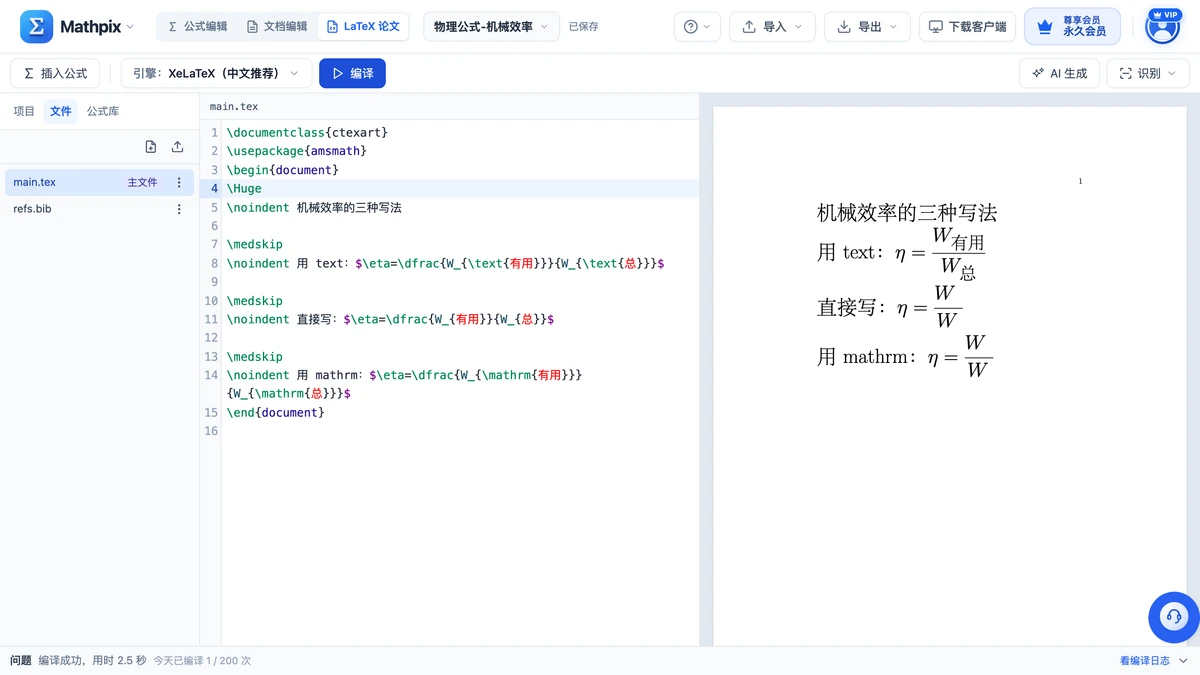
在编辑页的「LaTeX 论文」标签(/latex)里写论文、把识别结果插进去之前,先把中文统一成 \text。
英文单词同理。公式里写 where、speed 这类单词不包 \text,会被当成一串变量排成斜体,单词之间的空格也会被吃掉。
改法:在 LaTeX 模式里补上 text 命令
识别后先出结果卡片,点「插入」,公式进了编辑区后:
- 把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」看源码,找出所有汉字。
- 没包的,套上
\text{和};包在\mathrm{…}里的,把命令名换成text。 - 顺手核对汉字本身:字小或笔画细时可能认成形近字,对照原图改正。
- 切回「可视化」模式看一眼,汉字都在、位置没变就好。
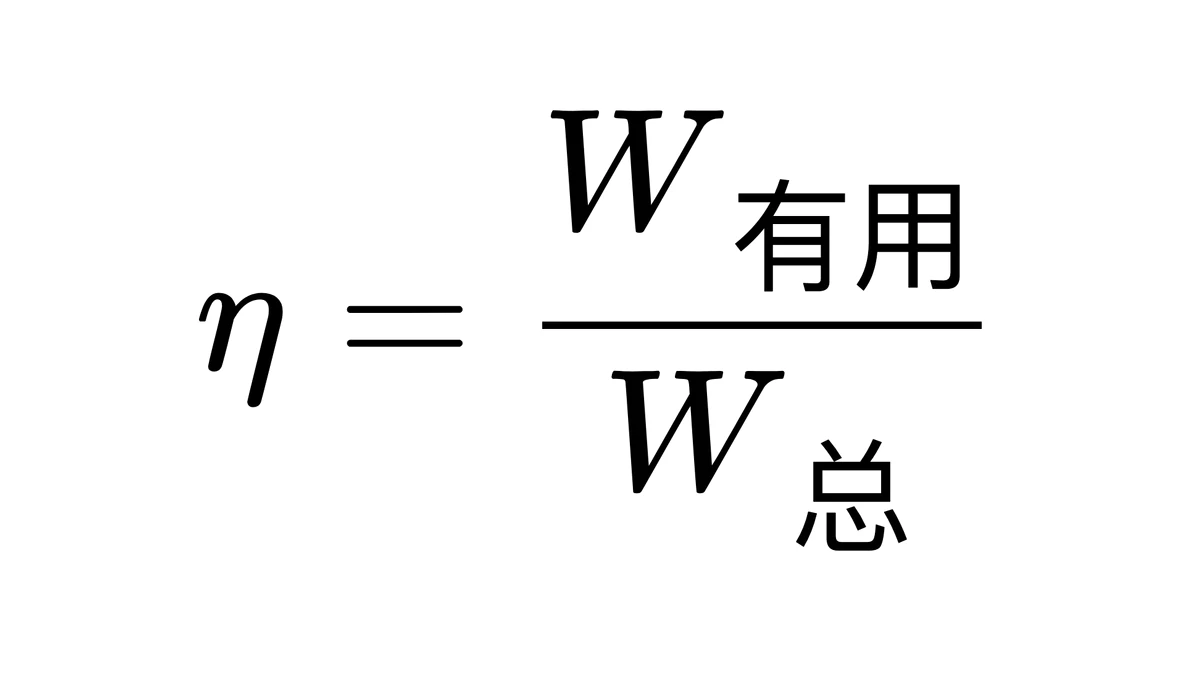
导出时的中文字体
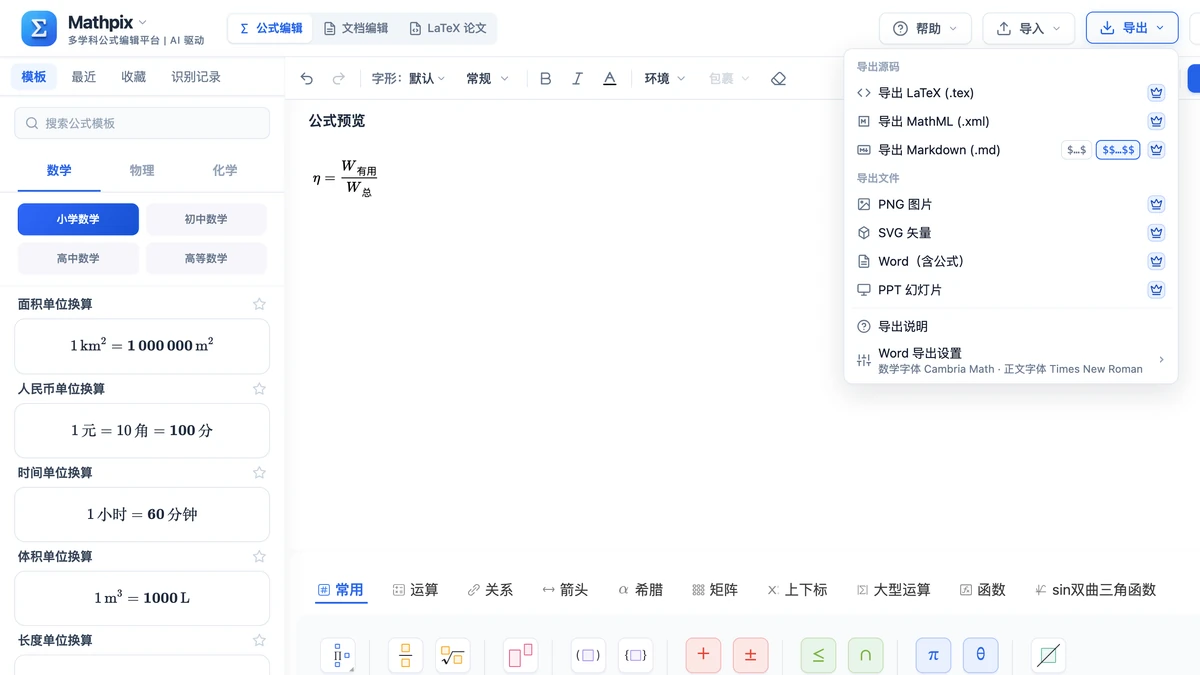
改好的公式从顶栏「导出」选「Word(含公式)」,得到的是 Word 原生公式,双击可改。字体规则是:
- 中文统一为宋体,没有单独的中文字体下拉;
- 数学字体管斜体字母,正文字体管数字、函数名、化学元素这类直立部分,两项都在顶栏「导出」菜单的「Word 导出设置」里选,只作用于 Word 导出;
- 在 WPS 里打开时,电脑没装所选字体,WPS 会换成它自己挑的字体,以当前版本为准。
导出成 LaTeX 源码的话,\text 里的汉字原样保留,放进 ctexart 文档就能编译出来。公式和表格混排的论文,可以参考论文公式表格转 LaTeX;转到 Word 后要查哪些地方,见LaTeX转Word公式编辑。
把物理课本里一条带中文下标的公式截图识别,在 LaTeX 模式里把汉字全部套上 \text,再导出一份 Word 公式看看宋体效果。
延伸阅读
- 论文公式表格转 LaTeX:公式与单元格分开看
- LaTeX转Word公式编辑:转换后先检查哪里
- 公式识别登录限制:开始前如何确认
常见问题
- 中文被识别成乱码怎么办?
- 先看是哪一种乱。汉字认成了形近字或拼音字母的,在 LaTeX 模式里直接把字改对,并放进 text 命令的花括号里;汉字整段消失、只剩字母的,多半是原图字太小或截进了正文,把图放大、只框公式重新识别。导出到 Word 后中文统一显示为宋体,这是现在的导出规则,不是乱码。