统计公式识别:求和、均值与希腊字母校对
更新于
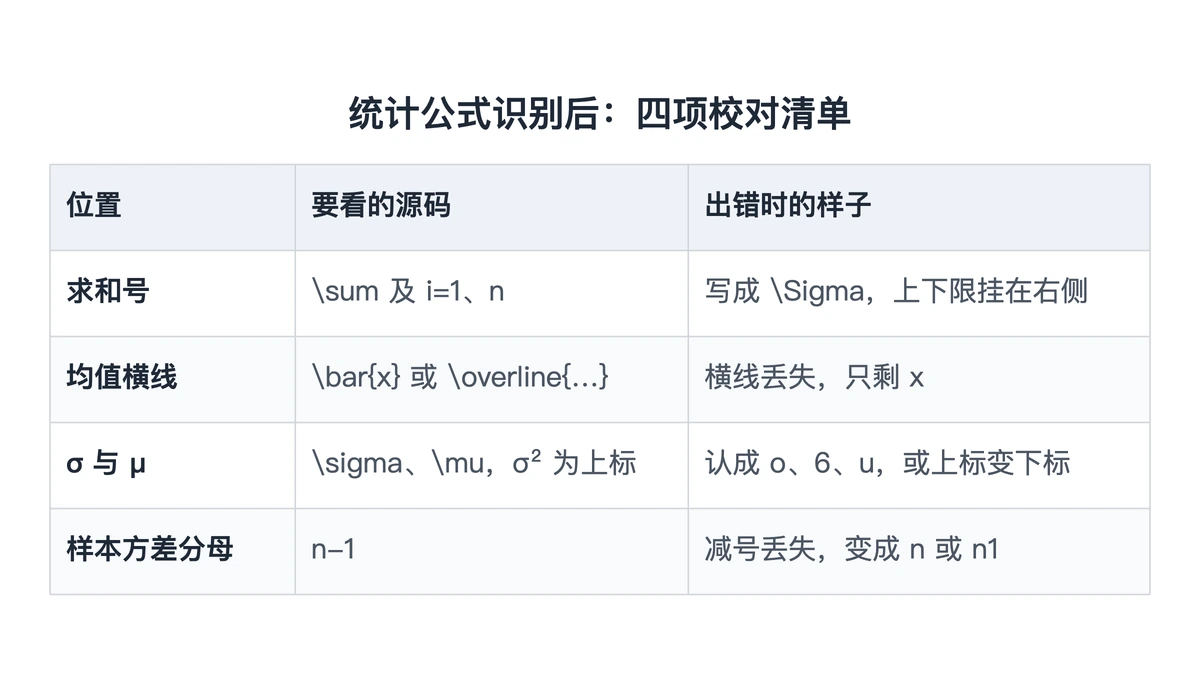
统计公式识别最容易出错的是四个位置:求和号的上下限、均值头上的横线、σ 与 μ 两个希腊字母,以及样本方差分母里的 n−1。截图时把页面放大、把求和号上下的小字截全;识别后切到「LaTeX」模式,按本文的四项清单逐项对照原图。图片识别要登录并开通本站会员。
截图前:让横线和上下限都看得清
统计公式里有两类「小东西」:均值 x̄ 头上的横线、求和号上下的 i=1 与 n。它们在原图里只有几个像素高,截图偏小时最先丢。
- 先放大再截。 课件、电子教材里的公式放大到横线和上下限都清楚,再用系统截图框住。
- 上下留白。 求和号上方的 n、下方的 i=1 各留出一点空白,别贴着边裁。
- 一张图一条公式。 统计表旁边夹着的公式单独框出来,表格里的数字留在原处。
- 格式与大小。 图片识别收 PNG、JPG、BMP、WEBP、GIF,单张不超过 20MB。
识别步骤:从截图到可改的源码
- 在公式编辑页点「识别」→「图片识别」,打开「图片公式识别」弹窗。
- 用截图的,在弹窗开着时按 Ctrl+V(Mac 上 ⌘V),识别直接开始;用图片文件的,拖进上传区后点「开始识别」。
- 在结果卡片点「插入」,公式进入编辑区后,把公式工具栏右端的「LaTeX / 可视化」开关切到源码。
- 按下一节的清单逐项对照原图修改,改完点「可视化」看排版。
一页教材上有好几条统计公式时,逐条截图、逐条识别,每识别完一条就核对一条,再截下一张。
弹窗上传区下方的「识别样例」是线上识别的原样输出,包括求根公式、矩阵和分段函数三组,没有统计公式;下文的清单与配图是按统计公式的结构整理的校对要点。
四项校对清单
以样本方差为例,校对完成后的源码应当是:
s_{x}^{2}=\frac{1}{n-1}\sum_{i=1}^{n}\left(x_{i}-\bar{x}\right)^{2}
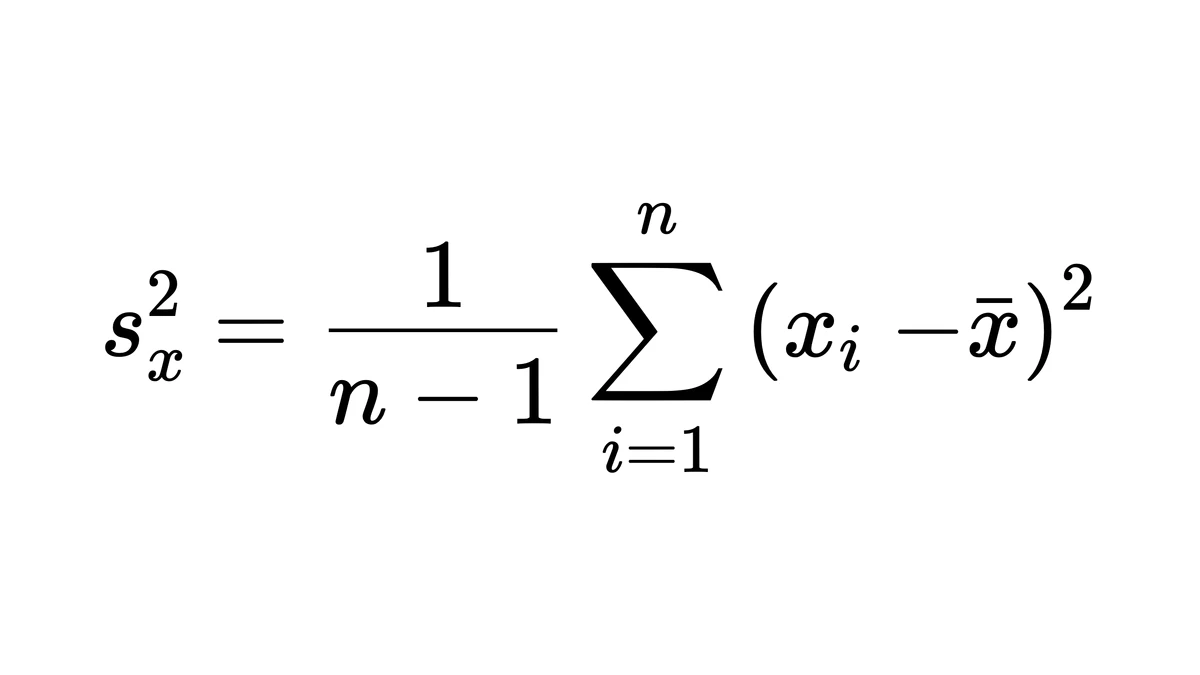
1. 求和号是不是求和命令。 希腊大写字母 Σ 和求和号外形接近,识别结果可能写成 \Sigma 而不是 \sum。两者在独立成行时差别明显:\sum 的上下限排在符号正上方和正下方,\Sigma 的上下限挂在右侧,像普通的上下标。发现是 \Sigma,把命令名换成 sum,上下限的写法不用动。
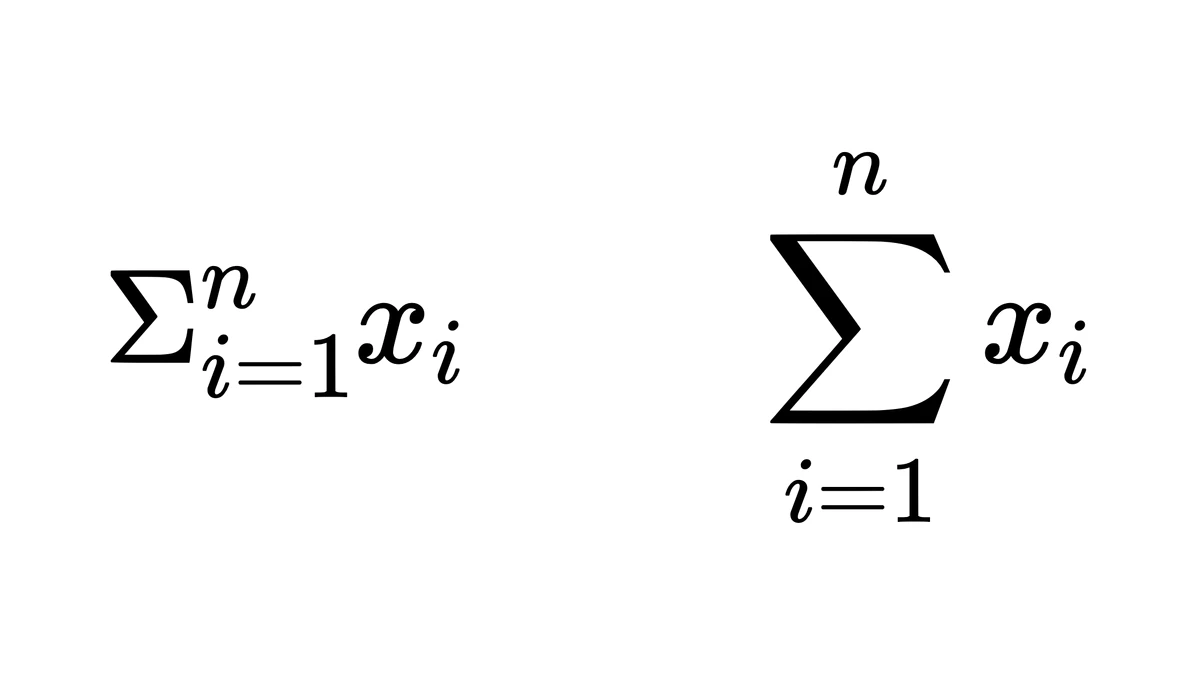
2. 均值横线还在不在。 单个字母的均值写 \bar{x};横线要盖住好几个字符时(比如 xy 这个乘积的均值)写 \overline{xy}。横线丢了,x̄ 就变成了 x,意思从「样本均值」变成「某个观测值」。
3. σ 与 μ 认对没有。 这两个字母都靠一个小笔画区分:σ 顶上那一横糊掉就和 o 差不多,μ 左边往下伸的长竖不明显就像 u。在源码里确认它们写成 \sigma、\mu;σ² 的 2 应当是上标,写成下标就成了第二个 σ。估计量头上的尖角 μ̂ 写 \hat{\mu},漏掉尖角,估计值和总体参数就混在一起了。
4. 分母是 n−1 还是 n。 样本方差的分母是 n−1,减号很短,截图偏小时会被丢掉,分母就成了 n 或 n1。
做完之后:代一组数手算一遍
四项对完,再用一组简单数据把公式手算一遍,能抓出清单漏掉的错。取 2、4、4、5、5 五个数:
- 均值 x̄ = (2+4+4+5+5) ÷ 5 = 4;
- 离差平方和 = 4 + 0 + 0 + 1 + 1 = 6;
- 按 n−1 做分母,s² = 6 ÷ 4 = 1.5;分母若被认成 n,得到的是 6 ÷ 5 = 1.2。
同一组数,两个结果差得明显,回头看分母就知道是哪一处出了问题。标准化公式也可以这样验:把均值、σ 和 n 代进去,看结果与教材例题是否一致。
z=\frac{\bar{x}-\mu}{\sigma/\sqrt{n}}
截图里上下标看不清时怎么补救,见截图公式上下标识别;开始识别前想确认账号状态,看公式识别登录限制。
实验报告的数据处理一节里那条样本方差,今天就可以截图识别:四项清单过一遍,再拿 2、4、4、5、5 手算核对分母,确认是 1.5 而不是 1.2。
延伸阅读
常见问题
- x̄识别成x怎么办?
- 把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」模式,给那个 x 套上均值命令 bar 和一对花括号,再切回可视化模式,看 x 头上是否出现短横线。横线丢失多半是截图太小,横线只有一两个像素宽,被当成噪点去掉了;下次先把页面放大到横线清楚可见再截图识别。