公式识别器输出后为何仍要人工复核
更新于
公式识别器给出一条排版正常的等式后,人很容易直接把它放进文档。问题是,一个负号读成横线、一个下标回到正文高度,都可能留下“看着像”的结果。人工复核的目的不是重新抄一遍,而是用不同检查动作发现字符、结构和语义三个层面的偏差。
在相近字形上做第一轮停留
将原图和识别结果放在便于交替查看的位置,从左向右按项比较。数字零与字母 O、数字一与小写 l、乘号与字母 x,都是需要放慢速度的位置。不要一看到熟悉的公式就按记忆补读,因为教材可能恰好换了变量,或使用与你熟悉写法不同的约定。
细小标记应单独检查一遍。小数点、导数撇号和上方的点容易被压缩或底灰掩盖,漏掉后不一定影响预览。可先数原图里的这些标记,再逐一在结果中找到对应位置。若图像放大后仍然无法辨认,把它记录为待确认,不要让一个猜测字符混进已经核对的结果。
来源图片也需要保留到复核结束。仅凭输出文本无法判断某条短线原本是减号还是分式横线的一部分。对争议字符应回到较完整的原页,参考同页相同符号的写法,而不是对着被裁切的小图反复放大。
按包围关系重读一遍表达式
第二轮不再逐字读,而是查看谁包含谁。分数线上面和下面各有哪些项,根号横线覆盖到哪里,外层括号把哪几部分括在一起。把结果按这种包围关系口述出来,常能发现“字全都在,位置却不对”的错误。
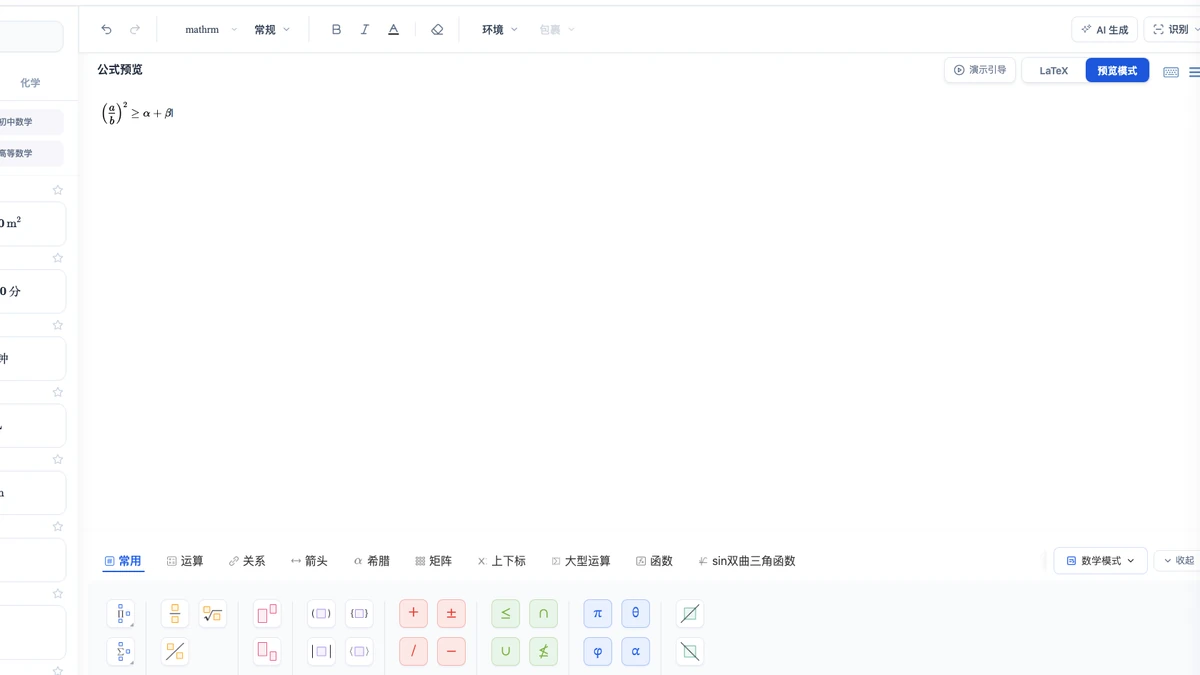
以括号后的平方为例,它可能表示括号整体的平方,也可能只属于最后一个变量。两种式子字符相近,数学意义不同。检查上下标时应找到它的宿主,再看脚标内部是否有多个字符。长式子还要核对等号两边的项数,避免换行之后有一项被当作另一条公式丢掉。
如果结果含矩阵,先比外框和行列数,再比每格内容。某一行缺了一个空位可能让后面的数字整体错列,这种问题不能通过改单个数字解决,必须恢复原来的行列关系。
回到题干检查式子到底在说什么
第三轮检查需要查看公式周围的文字。原文是定义、近似关系,还是在某个条件下成立的等式,决定了这条表达式如何使用。若近似号被读成等号,预览仍会正常;若条件在裁切图外,单看公式本体甚至找不到缺失之处。
物理资料要看变量单位和方向约定,概率资料要看事件及取值范围。将这些说明与输出一起比较,确认引用时没有改变语境。发现原稿与学过的结论不同,应先查原页是否还有条件,不要为了“纠正”识别结果而擅自改写作者原意。
当原文确有疑点,可在自己的整理记录中注明问题和来源位置,待查证后再处理。忠实转录与数学勘误是不同任务,二者的改动依据都应该留下,避免以后无法分辨错误发生在原资料还是整理过程。
将已核实的改动落实到编辑稿
在本站,图片识别需要登录和会员,取得的公式可以继续在编辑器中修改。先处理明显的字形错误,再调结构,能让每一步改动更容易确认。两种编辑模式可配合使用,查看代码的同时切回「可视化」检查层级表现。
改完后应再比一次整式,尤其是刚调整过括号或行列的位置。准备导出时切回「可视化」,并按登录与会员要求操作。最终保存的结果应当仍能对应到原图编号;未来发现引用条件有变化,才不必从头查找来源。
延伸阅读
常见问题
- 公式识别器的结果为什么还要复核?
- 识别结果可能读对了字母却放错层级,也可能漏掉原文中的适用条件。需要分别比较字符、表达式结构和上下文,确认与来源一致后再用于文档。