AI识别公式图片的效果与局限:5类常见错误
更新于
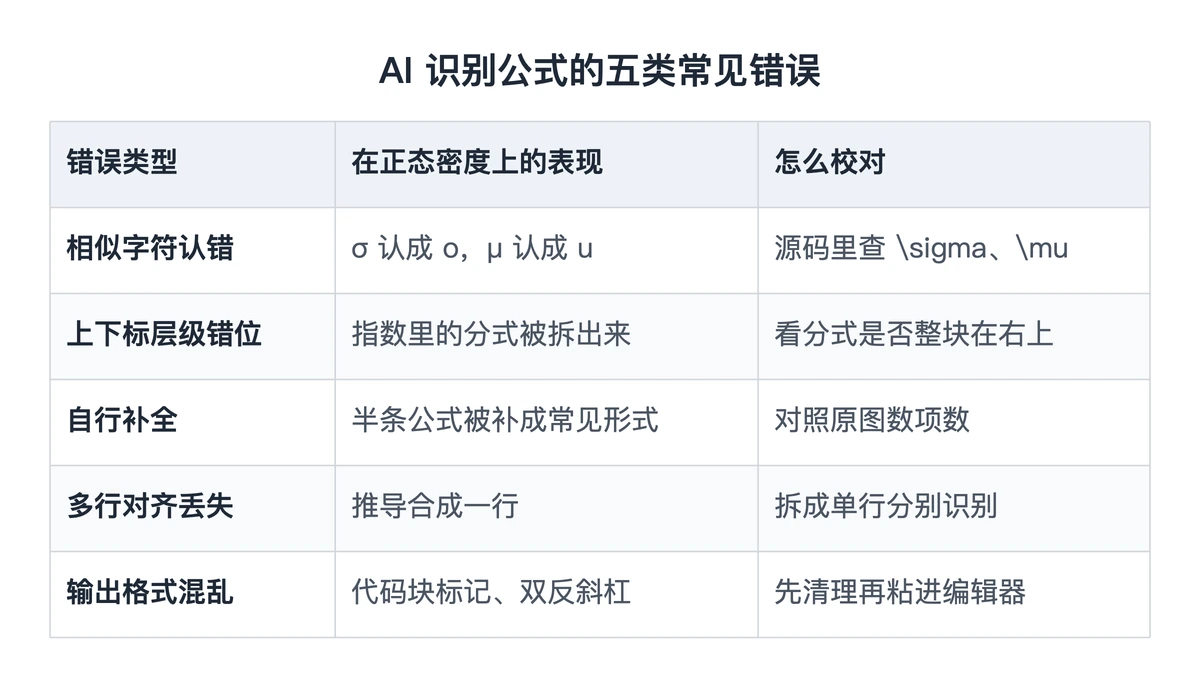
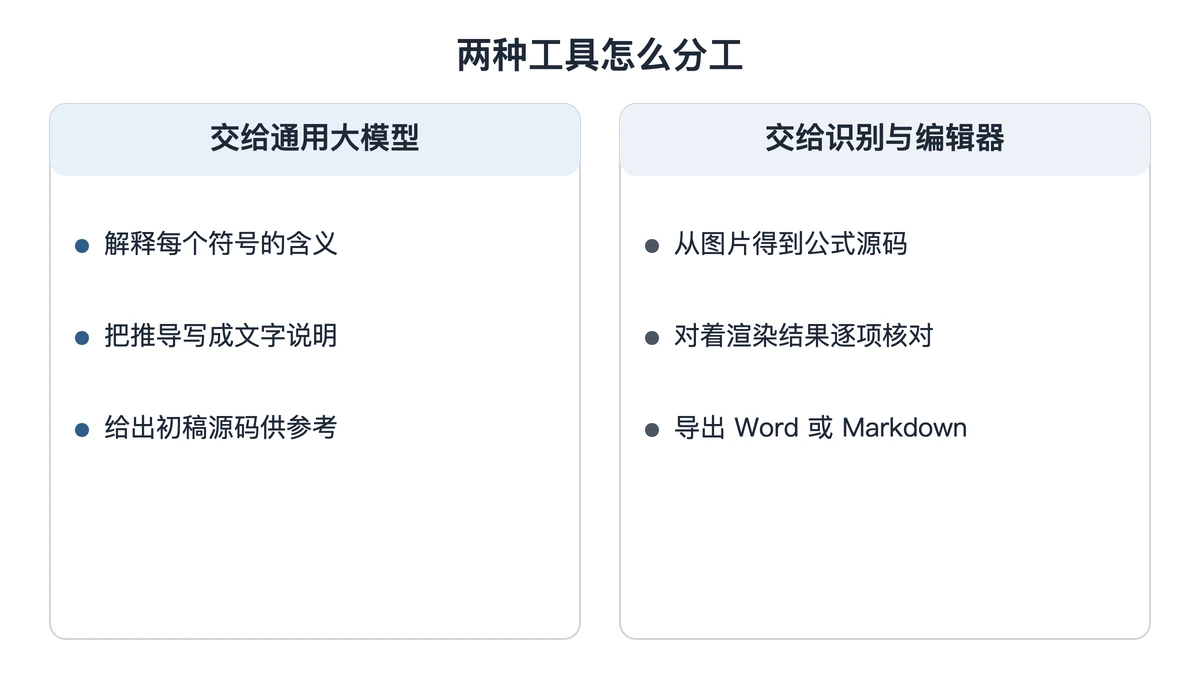
用通用大模型做 AI识别公式,按截至 2026-09 的常见使用经验,印刷清楚的单行公式常能给出可用的 LaTeX,但有五类错误反复出现:相似字符认错、上下标层级错位、看不清的地方被自行补全、多行推导的对齐丢失、输出格式和定界符混乱。前四类是内容错,第五类是格式错,而格式错恰恰是转成 Word、Markdown 时最先暴露的问题。比较稳的配合是:公式交给带预览的识别工具得到源码,在编辑器里对着渲染结果核对,再导出成需要的格式。
输入从哪来,先怎么处理
公式图片通常来自三处:课件或网页截图、手机拍的纸质资料、PDF 里截下来的一块。不管来源是哪一种,送去识别之前都先做同一件事:裁到只剩一条公式,四周留一点空白,题号、式号和前后的文字都去掉。
大模型对整页图片会顺手做很多「理解」,公式旁边的一句话可能被当成公式的一部分,也可能被它改写。一张图一条公式,出错时才定位得到,改起来也只需要动这一条。
手机照片先传到电脑,存成 PNG、JPG 或 BMP;照片有透视变形的,先裁正再用。本站「图片识别」的格式与大小以上传区下方提示为准,使用前要登录并开通本站会员。
五类常见错误与校对方法
下面用正态分布的密度函数举例,它同时有希腊字母、根号、分式和嵌在指数里的分式,五类错误几乎都能在它身上出现:
f(x)=\frac{1}{\sigma\sqrt{2\pi}}e^{-\frac{(x-\mu)^{2}}{2\sigma^{2}}}
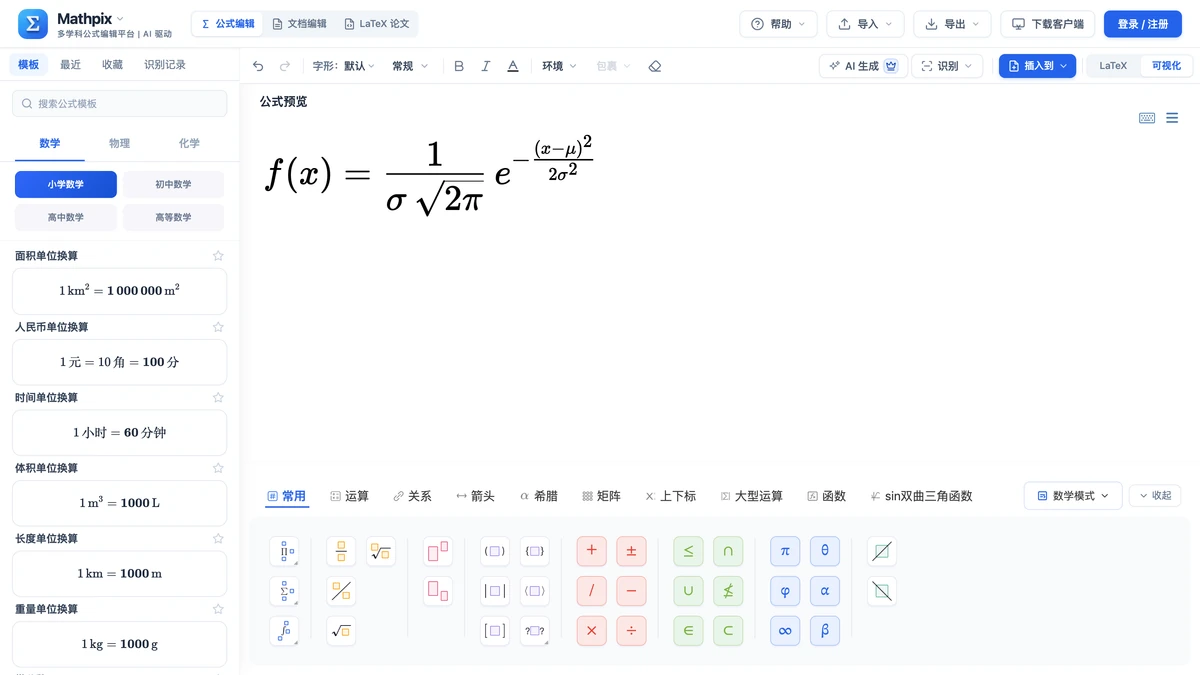
- 相似字符认错:σ 被认成 o 或 6,μ 被认成 u。校对时在源码里确认是
\sigma、\mu,希腊字母的辨认方法见希腊字母识别。 - 上下标层级错位:指数里的分式被拆出来,变成 e 的 −(x−μ)² 次方再整体除以 2σ²。看渲染结果时,分式应当整块缩小在 e 的右上方。
- 自行补全:截图只截到半条公式,模型按常见形式把后半段补齐;或者把原文里的非标准记号改成教材写法。对照原图数一遍项数,多出来的项要删。
- 多行对齐丢失:三行推导被合成一行,或者等号不再上下对齐。多行内容建议拆成单行分别识别,再在文档里排版。
- 输出格式混乱:源码被包在代码块标记里,行内和独立公式的定界符混用,反斜杠被写成两个,下划线前面多出转义符。这类问题渲染时常常直接报错,是最先要清理的。
和专用识别配合的转换步骤
- 把裁好的公式图片在编辑器里走「识别」→「图片识别」,在「图片公式识别」窗口按 Ctrl+V(Mac 上 ⌘V)粘贴截图,识别会直接开始;上传图片文件的,选好后点「开始识别」。
- 在结果卡片点「插入」,公式进入编辑区,预览区就是渲染后的公式,先和原图整体比一眼,再把公式工具栏右端的「LaTeX / 可视化」开关切到「LaTeX」看源码。
- 手上已经有大模型给的 LaTeX,也可以先删掉代码块标记和多余的定界符,粘进 LaTeX 模式里看渲染,公式编辑与预览不需要登录。
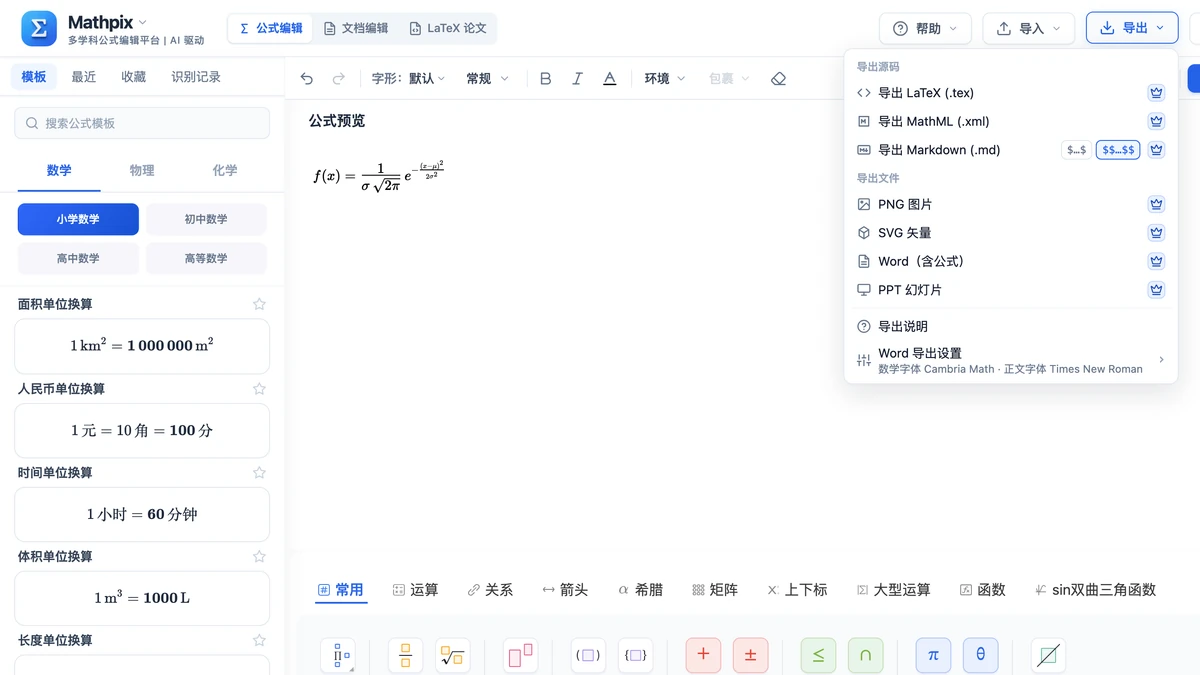
- 核对完切回「可视化」模式,顶栏「导出」里选「Word(含公式)」,或选「导出 Markdown (.md)」并在行尾两个按钮里选行内
$…$还是独立$$…$$。
大模型在这条流程里仍然有用:让它解释公式里每个符号的含义、把推导过程写成文字,都比让它直接输出最终源码更可靠。
转换后要检查的三处
层级。 打开导出的文件,看指数、分式、根号的嵌套是否和原图一致,正态密度里那块指数分式最容易出问题。
字符。 希腊字母、上撇号、带帽的字母逐个看,化学式还要看电荷和下标,方法见化学式识别。
格式。 Word 里点一下公式,能进入公式编辑状态才是公式对象;Markdown 文件里看定界符是否统一成你选的那一种,下划线前面没有多余的反斜杠。
下次拿到大模型给的一段公式源码,先粘进编辑器的 LaTeX 模式看它渲染出来是不是原图的样子,对上了再导出成 Markdown 放进笔记。
延伸阅读
常见问题
- AI识别的公式要逐字核对吗?
- 要核对,但可以有重点。先看渲染出来的公式和原图是否同形,结构层级对上了,再逐个看相似字符和上下标;最后看输出格式,比如定界符是否统一、有没有多出代码块标记。短公式一遍就能看完,长推导建议一行一行对。